
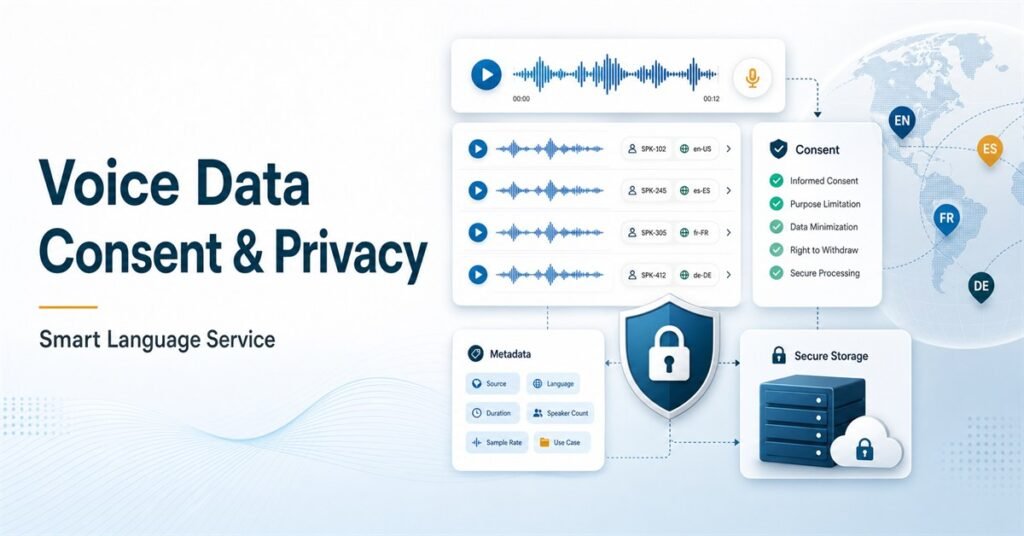
Por qué importa el consentimiento en la recopilación de datos de voz
La recopilación de datos de voz es esencial para crear reconocimiento de voz, asistentes de voz, análisis de llamadas y sistemas de IA conversacional. Pero la voz no es un formato de datos cualquiera. Una grabación puede revelar idioma, acento, rango de edad, pistas de ubicación, entorno de fondo, condiciones de salud, emociones y a veces nombres u otra información personal. Por eso, el consentimiento y la privacidad son parte central del proyecto.
Para los compradores, el mayor riesgo es asumir que un proveedor puede recopilar primero y resolver el cumplimiento después. En realidad, el texto de consentimiento, los registros de participantes, las reglas de almacenamiento, la anonimización y los procedimientos de eliminación deben definirse antes de iniciar el reclutamiento. Si estos elementos no están claros, el dataset puede ser difícil de usar, auditar o aplicar en entrenamiento de modelos dentro de entornos regulados.
Empiece por el propósito del dataset
Un proyecto sólido comienza con un caso de uso claro. ¿Se recopila lectura en voz alta para ASR, conversaciones espontáneas para sistemas de diálogo, audio de call center para análisis de calidad o palabras de activación para un dispositivo? Cada propósito afecta el consentimiento, las instrucciones, los metadatos y el proceso de revisión.
La declaración de consentimiento debe explicar qué se grabará, por qué se recopila, cómo se puede usar, si se utilizará para entrenamiento de modelos de IA y si puede compartirse con procesadores, revisores o socios tecnológicos. Los participantes no deberían tener que adivinar si su voz se usará solo para una prueba o para futuras mejoras del modelo.
Defina claramente los derechos de los participantes
Un buen consentimiento es específico, comprensible y trazable. Los participantes deben saber si pueden retirarse, durante cuánto tiempo, a quién contactar y qué ocurre con las grabaciones ya procesadas. Si el proyecto involucra menores, empleados, contratistas, contextos médicos o temas sensibles, puede requerir salvaguardas adicionales.
Los compradores también deben preguntar cómo se guardan los registros de consentimiento. Un dataset sin documentación confiable puede convertirse en un riesgo. Cada grabación debe poder vincularse a un consentimiento válido sin exponer información personal innecesaria a equipos de anotación o revisión.
Controle los metadatos recopilados
Los metadatos son útiles para proyectos de IA de voz. Idioma, dialecto, rango de edad, género, tipo de dispositivo, entorno de grabación y región ayudan a evaluar cobertura y rendimiento. Pero los metadatos también aumentan el riesgo de privacidad si son demasiado detallados o se combinan con información identificable.
Una regla práctica es recopilar solo los metadatos necesarios para el objetivo del proyecto. Si no se requiere ubicación por ciudad, la región puede ser suficiente. Si no se necesita edad exacta, los rangos de edad son más seguros. Comprador y proveedor deben acordar el esquema antes del reclutamiento.
Planifique almacenamiento, acceso y seguridad
Las grabaciones deben almacenarse en sistemas controlados con permisos claros. Los compradores deben preguntar quién puede acceder al audio bruto, quién puede acceder a las transcripciones, quién puede exportar archivos y cómo se registra el acceso. En proyectos transfronterizos, la ubicación de almacenamiento y las reglas de transferencia también pueden importar.
La seguridad debe incluir cifrado, acceso limitado, transferencia segura, plazos de retención y reglas de eliminación. También debe definir qué ocurre si un participante se retira o cuando termina el proyecto. Estos detalles son más fáciles de gestionar cuando forman parte del diseño desde el primer día.
La anonimización necesita expectativas realistas
Los datos de voz pueden ser difíciles de anonimizar por completo porque la voz misma puede identificar a una persona. Eliminar nombres de una transcripción ayuda, pero no convierte el audio bruto en anónimo. Algunos proyectos requieren eliminación de información personal, separación de ID de hablante o supresión de segmentos sensibles.
Los compradores deben aclarar el nivel esperado de anonimización y lo que es técnicamente realista. El proveedor debe explicar si la redacción se aplica al audio, la transcripción, los metadatos o los tres. Esto evita malentendidos durante la entrega.
Qué preguntar a un proveedor de datos de voz
Antes de empezar, los compradores deben preguntar: ¿qué plantilla de consentimiento se usará? ¿Cómo se reclutan y verifican los participantes? ¿Cómo se vinculan los consentimientos con las grabaciones? ¿Qué metadatos se recopilan? ¿Dónde se almacena la información? ¿Quién puede acceder? ¿Cómo se gestionan las retiradas? ¿Qué controles confirman que las grabaciones coinciden con el consentimiento y el alcance del proyecto?
Estas preguntas no son formalidades legales. Determinan si el dataset puede ser confiable, reutilizable, auditable y entregado sin retrasos evitables.
Cómo ayuda Smart Language Service
Smart Language Service ayuda a equipos de IA a diseñar flujos de recopilación de voz que equilibran utilidad del dataset, consentimiento, privacidad y control operativo. Apoyamos reclutamiento de participantes, instrucciones multilingües, planificación de metadatos, control de calidad de grabación, transcripción, anotación y validación del dataset.
Para equipos que construyen IA de voz en varios idiomas y mercados, una planificación consciente de la privacidad reduce riesgos y mejora la confiabilidad del dataset. Cuando el consentimiento y el manejo de datos forman parte del flujo, los compradores pueden avanzar más rápido y con mayor confianza.