
Elija servicios de anotación de vídeo por la tarea del modelo
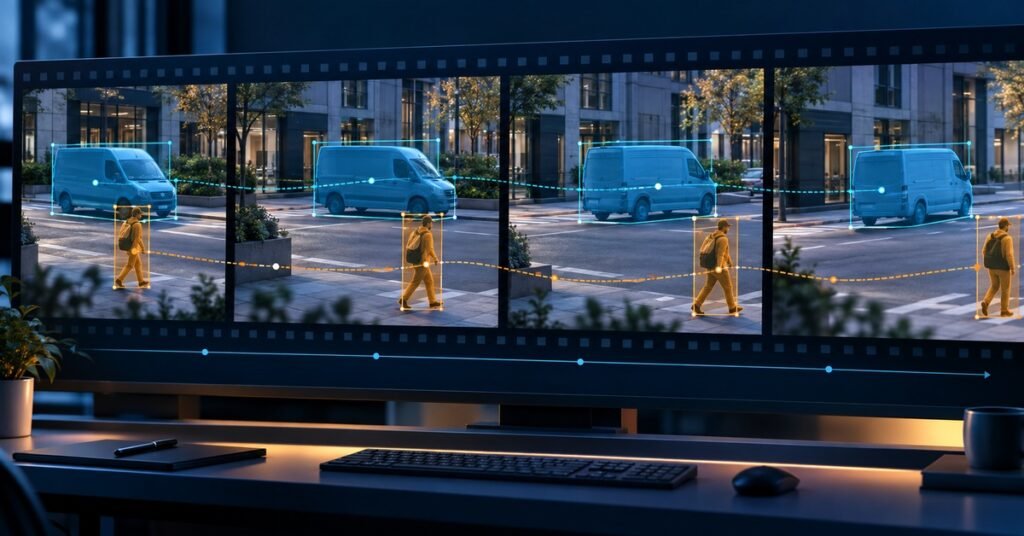
Los servicios de anotación de vídeo convierten secuencias de fotogramas en datos de entrenamiento que conservan qué ocurrió, dónde ocurrió y cómo cambió el mismo objeto con el tiempo. El comprador debe definir primero la decisión del modelo: detectar un objeto, mantener su identidad, estimar una pose, segmentar su contorno, reconocer una acción o localizar un evento. Después debe elegir la anotación más sencilla que aporte esa evidencia. Tratar el vídeo como una carpeta de imágenes independientes puede eliminar la información temporal que justificó usar vídeo.
Por eso, la comparación comercial va más allá del precio por fotograma. Un alcance utilizable define unidad de trabajo, selección de fotogramas, identidad, oclusión, interpolación, ontología, formato, métricas y prueba de aceptación. También separa velocidad de producción y coste del resultado aceptado: etiquetas baratas que exigen reparar identidades o convertir formatos pueden costar más que un flujo gestionado bien diseñado.
Esta guía ayuda a equipos de visión artificial, robótica, retail y movilidad a comparar métodos, decisiones de fotograma o secuencia, consistencia temporal, herramientas, formatos, costes y evidencia de piloto.
Relacione el tipo de anotación con la salida del modelo
El mismo clip admite varios datasets válidos, pero cada uno responde una pregunta distinta.
- Clasificación de fotograma o clip: asigna una categoría a una imagen, toma o secuencia, como normal/anómalo, inicio de pago, carretilla activa o tipo de maniobra. Es eficiente si no importa la posición, pero necesita reglas para los límites de la acción.
- Cajas delimitadoras: localizan instancias con rectángulos. Sirven para detección y muchos usos de tracking cuando no hace falta un contorno exacto. Especifique si la caja cubre solo píxeles visibles o estima el objeto completo durante una oclusión parcial.
- Tracks de objetos: conectan la misma instancia entre fotogramas mediante un ID estable. Permiten tracking multiobjeto, trayectorias, permanencia e interacciones. Los cambios de identidad y tracks rotos se convierten en defectos principales.
- Polígonos o máscaras de instancia: delinean cada objeto. Son útiles para razonamiento espacial preciso, robótica, inspección y separación de objetos superpuestos, pero el contorno cambia en el tiempo y eleva el esfuerzo.
- Segmentación semántica: asigna una clase a cada píxel relevante sin conservar necesariamente la identidad. La segmentación de instancia separa objetos individuales; los esquemas panópticos combinan fondo e instancias. El comprador debe especificar qué representación espera el pipeline.
- Puntos clave y esqueletos: marcan articulaciones, puntas de herramientas, ruedas o esquinas. Hay que fijar orden, lateralidad y estados de visibilidad.
- Acciones, eventos y segmentos temporales: indican inicio, fin, actor y, si procede, relación: una persona recoge un producto, un vehículo cambia de carril o una máquina entra en una zona. La tolerancia del límite se mide en fotogramas o tiempo.
El paper de Microsoft COCO es una fuente primaria para detección y segmentación de instancia. El paper de BDD100K muestra cómo una colección de vídeo puede admitir tareas heterogéneas como detección, carriles, segmentación y tracking multiobjeto. Estas referencias evidencian que “anotación de vídeo” no es un único entregable: hay que nombrar tarea y representación.
Combine capas solo si el valor posterior lo justifica. Un proyecto de retail puede necesitar tracks de personas, polígonos de estantería y eventos de recogida, pero no máscaras para cada persona. Un robot puede requerir máscaras y puntos clave en objetos manipulables, mientras el fondo solo necesita regiones semánticas.
Decida entre fotogramas independientes y secuencias
La primera decisión de alcance consiste en tratar cada fotograma como muestra independiente o como miembro de una secuencia seguida.
Los fotogramas independientes encajan cuando el modelo consume imágenes fijas, el orden temporal aporta poco o el muestreo busca instantáneas variadas. Facilitan el trabajo paralelo y la exportación a formatos de imagen. Sin embargo, seleccionar cada n fotogramas sin observar el movimiento puede sobrerrepresentar duplicados, perder eventos breves o asignar identidades incoherentes.
La anotación por secuencia es necesaria cuando importan identidad, movimiento, duración, transición o interacción. La unidad debe ser un clip completo o una toma definida, con reglas para objetos que entran, salen, quedan ocultos, reaparecen o cruzan un corte. El anotador necesita suficiente contexto anterior y posterior para aplicar la decisión de identidad esperada en evaluación.
La interpolación de keyframes reduce trabajo en movimientos previsibles. La documentación oficial de vocabulario de CVAT describe el modo de vídeo mediante objetos track: se anotan keyframes y se interpolan formas intermedias. Su guía de tracking con polígonos también exige conservar punto inicial y dirección. La automatización acelera; no demuestra aceptación. Movimiento rápido, deformación, cortes, oclusión y cambios de escala exigen más keyframes o corrección manual.
Un plan puede combinar intervalos fijos, selección por movimiento o cambio de escena, etiquetado denso alrededor de eventos y sobremuestreo de objetos pequeños, oclusión, poca luz, meteorología y vistas raras. Mantenga fotogramas relacionados en la misma partición de entrenamiento, validación o prueba. Los fotogramas vecinos casi idénticos pueden filtrar información entre particiones y producir una evaluación irreal.
Convierta la consistencia temporal en criterio de aceptación
Una caja puede ser correcta en un fotograma y el track completo estar equivocado. El QA debe medir precisión espacial y continuidad.
Un ID debe pertenecer a una sola instancia física. Si dos objetos se cruzan, revise aproximación, solapamiento y separación. Defina cuándo puede reanudarse una identidad tras una oclusión y cuándo debe comenzar un track nuevo. Si el formato lo permite, distinga oculto, fuera del campo y ausente de la escena.
Defina el comportamiento geométrico. Cajas y máscaras no deben oscilar sin movimiento correspondiente. Mantenga una regla uniforme: píxeles visibles, extensión amodal estimada o convención por clase. Revise formas interpoladas en puntos medios y cambios de movimiento, no solo en keyframes.
Los atributos persistentes, como clase, color o tipo, no deben fluctuar. Atributos variables, como pose, visibilidad, acción o señal, necesitan transiciones permitidas. Un evento requiere reglas de inicio y fin, por ejemplo, “comienza con el primer contacto mano-objeto y termina cuando la persona controla el producto”, además de una tolerancia numérica.
El informe debe separar acuerdo geométrico, exactitud de clase y atributos, completitud, fragmentación, cambios de ID, acuerdo de límites de evento, eventos omitidos y validación del esquema. Los umbrales dependen de la tarea: un sistema de seguridad con objetos pequeños puede priorizar omisiones sobre IoU medio; un modelo de trayectorias puede aceptar cajas algo holgadas y rechazar todo cambio de identidad. Exija método de adjudicación y comprobación de regresión tras corregir.
Nuestras guías de anotación de imágenes para visión artificial y de instrucciones que reducen retrabajo aportan criterios adicionales de geometría y casos límite.
Especifique herramientas, ontología y formato antes de producir
Confirme que la herramienta admite vídeos largos, navegación precisa, velocidad, keyframes, interpolación, IDs, oclusión, máscaras, puntos, segmentos temporales, comentarios, auditoría, permisos y colas de revisión. Pruébela con resolución, códec, frame rate y duración representativos: una lista de funciones no prueba rendimiento sobre el material real.
Versione ontología e instrucciones juntas. Cada etiqueta necesita definición, inclusión, exclusión, ejemplos positivos y negativos, jerarquía, atributos y política de dificultad. Cubra truncamiento, grupos, reflejos, pantallas, sombras, objetos pequeños, blur, duplicados, cortes e incertidumbre. Actualice un registro de decisiones cuando el piloto revele un caso nuevo.
Diseñe la exportación antes de la primera etiqueta: origen de coordenadas, unidades y redondeo; numeración, timestamps, frame rate variable y checksum; IDs de clase, track y anotación; orientación de polígonos, codificación de máscaras, orden de puntos, visibilidad e intervalos; nombres, carpetas, manifiestos, versiones y transformaciones.
El JSON estilo COCO es común para detección, segmentación y puntos en imágenes, pero no resuelve por sí solo la identidad en vídeo. El formato nativo puede conservar tracks y crear dependencia de plataforma. Un JSON propio puede encajar y añadir validación. Para etiquetado multisenor y escenarios, ASAM OpenLABEL ofrece una especificación JSON para objetos, frames, streams, sistemas de coordenadas, acciones, eventos y relaciones. Elija un formato porque el loader de destino lo valida, no porque su nombre sea conocido.
Pida una exportación de muestra durante la compra. Ejecútela en el loader de entrenamiento, visualice anotaciones al azar y compruebe conteos e IDs. Un archivo válido contra el esquema puede seguir usando coordenadas equivocadas o romper la identidad temporal.
Comprenda los factores reales de coste
El coste depende de eventos de anotación y complejidad de revisión, no solo de horas de vídeo. Un minuto de entrevista fija y un minuto de cruce concurrido duran lo mismo, pero contienen cantidades de objetos y movimiento radicalmente distintas.
Los factores incluyen fotogramas efectivos, objetos medios y máximos por frame, duración de tracks, entradas y salidas, densidad de oclusión, tipo geométrico, clases, atributos y relaciones, resolución, frame rate, carga de corregir preetiquetas, búsqueda de clases raras, especialización, seguridad, revisión, adjudicación, retrabajo, conversión, validación y gestión de cambios.
Compare coste por secuencia aceptada u otra unidad verificada, no solo coste por frame. Entregue a todos la misma muestra, ontología, salida, plan QA y umbral. Separe precios de preparación, producción, revisión, adjudicación y corrección.
Para una diligencia más amplia sobre alcance, modelo de entrega y encaje del proveedor, combine esta evidencia específica de vídeo con nuestra comparación de empresas de servicios de datos para IA.
Supongamos que el proveedor A ofrece cajas baratas cada diez frames sin revisar continuidad. B ofrece tracks por keyframes, interpola movimiento previsible, revisa transiciones de oclusión e informa cambios de ID. Si el modelo necesita trayectorias, A no ha cotizado una versión barata del mismo servicio: ha cotizado otro entregable que requerirá reetiquetado o reparación técnica.
La automatización puede ahorrar dibujo repetitivo, pero el ahorro depende del tiempo de corrección y distribución de errores. Compare flujos manual y asistido en las mismas secuencias. Registre producción, revisión, correcciones, rendimiento aceptado y defectos por condición. No convierta una afirmación general de productividad en pronóstico sin evidencia de muestra.
Ejecute un piloto que responda la decisión de compra
Un buen piloto es producción en miniatura, no un clip de demostración elegido para lucir bien. Incluya material normal y estratos difíciles: escenas densas, movimiento rápido, oclusión parcial y total, cámara móvil, blur, objetos pequeños, ambigüedad, cortes y eventos raros. Mantenga un conjunto gold o de adjudicación controlado por el comprador y oculto a producción.
Antes del piloto, acuerde tarea y representación, derechos y seguridad, reglas de secuencia y muestreo, ontología, identidad, oclusión, geometría y eventos, exportación válida, muestra y umbrales QA, escalado, responsabilidad de corrección, throughput después de revisión y control de cambios.
Durante el piloto mida trabajo por etapa, anotaciones aceptadas, categorías de error, defectos de identidad, tiempo de respuesta, cambios de guía, fallos de exportación y acuerdo entre revisores. Separe vídeo fácil y difícil. Un promedio que mezcla frames vacíos y escenas densas es mala evidencia para escalar.
Al cerrar, solicite anotaciones finales, exportación validada, registro de problemas, guía corregida, decisiones, informe QA y supuestos de escala. Revise varias secuencias completas de principio a fin y decida aprobar, revisar el alcance, hacer otro piloto focalizado o detenerse.
Lista del comprador:
- ¿La anotación apoya directamente la salida del modelo?
- ¿Muestreo y límites de secuencia son explícitos?
- ¿Identidad, oclusión, reentrada y cortes tienen reglas?
- ¿Inclusión y casos límite tienen ejemplos?
- ¿La herramienta maneja vídeo real sin errores de tiempo?
- ¿El formato pasó por el loader de entrenamiento?
- ¿Se miden por separado geometría, clase, tiempo y esquema?
- ¿El precio incluye revisión, adjudicación, corrección e informe?
- ¿Acceso, retención y borrado son adecuados?
- ¿El throughput se informa como salida aceptada por dificultad?
Una propuesta sólida de servicios de anotación de vídeo conecta las etiquetas con el modelo, conserva el significado temporal, prueba la compatibilidad y pone precio a calidad aceptada. Envíe a Smart Language Service una muestra representativa para recibir recomendaciones de método y coste; podemos diseñar el piloto, localizar la ontología cuando sea necesario, gestionar producción y revisión y entregar evidencia por secuencia.