
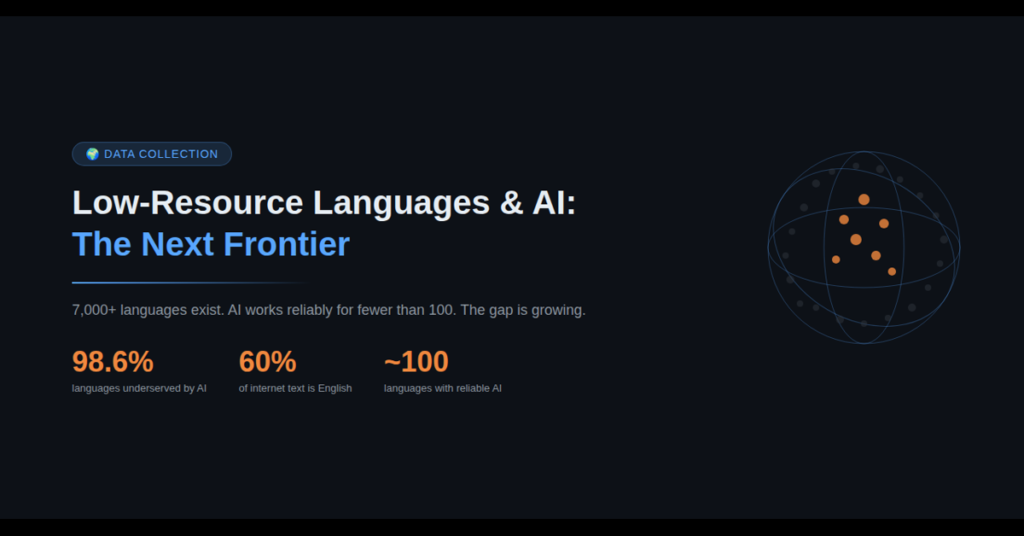
La brecha lingüística en IA
El inglés representa aproximadamente el 60% de todo el texto en internet. El chino mandarín, el segundo idioma del mundo por número de hablantes nativos, alcanza apenas el 5%. El suajili —hablado por más de 100 millones de personas en África Oriental— apenas se registra en los conjuntos de datos de la red.
Este desequilibrio aparece cada vez que alguien intenta usar un asistente de voz en amárico, hacerle una pregunta a un chatbot en quechua o ejecutar un análisis de sentimientos en publicaciones en yoruba. El modelo no falla porque el algoritmo sea malo. Falla porque los datos de entrenamiento simplemente no existen a escala.
A fecha de 2026, los principales modelos de lenguaje funcionan de manera fiable en aproximadamente 100 idiomas de los más de 7.000 que se hablan en el mundo. Eso significa que el 98,6% de los idiomas del planeta están desatendidos por la IA. Para las empresas que desarrollan productos en mercados emergentes, esto no es un problema académico — es un punto ciego competitivo.
Por qué persiste la escasez de datos
La recolección de datos de entrenamiento de alta calidad para idiomas de bajos recursos enfrenta tres desafíos que se superponen:
El contenido digitalizado es escaso. Muchos idiomas tienen ricas tradiciones orales pero corpus escritos limitados en línea. Puedes extraer miles de millones de oraciones en inglés de la web en una tarde. Para el tigriña o el k'iche', quizás encuentres unos pocos miles de documentos, y muchos están mal formateados o traducidos automáticamente desde otros idiomas, lo que los hace inservibles para entrenar.
La experiencia en anotación es difícil de conseguir. Incluso cuando encuentras datos en bruto, necesitas hablantes nativos que entiendan tanto el idioma como la tarea de anotación. Un lingüista que puede etiquetar partes de la oración en francés no está automáticamente cualificado para hacer lo mismo en bambara. Encontrar y verificar anotadores para idiomas subrepresentados requiere redes locales, no simplemente plataformas de crowdsourcing.
Los dialectos multiplican el problema. El "árabe" no es un solo idioma a efectos de IA. El darija marroquí, el árabe egipcio y el árabe del Golfo son mutuamente ininteligibles en la práctica. Un modelo entrenado en árabe estándar moderno tendrá dificultades para entender una llamada de atención al cliente en dialecto tunecino. Cada dialecto necesita su propio flujo de datos, y la mayoría no tiene casi ninguno.
El costo empresarial de ignorar idiomas de bajos recursos
Las empresas que tratan el soporte lingüístico como algo secundario enfrentan pérdidas medibles:
Cuando una importante aplicación de transporte lanzó en Nairobi, su interfaz de voz solo en inglés obligó a los conductores a escribir comandos mientras conducían — un problema de seguridad que contribuyó a una tasa de cancelación 23% más alta comparada con mercados con soporte de voz en idiomas locales. La empresa luego invirtió en la recolección de datos de voz en suajili y vio que la retención de conductores mejoró un 18%.
En el sector salud, los chatbots diagnósticos entrenados solo con literatura médica en inglés pierden el contexto cultural en las descripciones de síntomas. Un estudio del Instituto Africano de Ciencias Matemáticas encontró que las descripciones de síntomas en hausa e igbo suelen usar expresiones metafóricas que la traducción directa pierde por completo, lo que lleva a diagnósticos preliminares inexactos.
Para la automatización del servicio al cliente, la brecha es igualmente costosa. El informe de tendencias de experiencia del cliente 2026 de Zendesk encontró que el 67% de los consumidores en el sudeste asiático y el África subsahariana prefieren el soporte en su idioma local, pero menos del 30% de las plataformas de soporte empresariales ofrecen automatización fiable en esos idiomas.
Lo que la mayoría de los equipos hacen mal
El error más común que vemos es asumir que el soporte multilingüe significa traducir tu conjunto de datos en inglés. La traducción preserva las palabras, no los patrones de habla, las referencias culturales o la forma natural en que las personas se expresan en su lengua materna. Un modelo entrenado con datos traducidos del inglés sonará gramaticalmente correcto pero culturalmente ajeno.
Otro error frecuente es priorizar los idiomas de altos recursos primero y tratar los de bajos recursos como "fase dos". Para cuando llega la fase dos, la arquitectura del producto ya asume distribuciones de datos similares al inglés, y adaptar el soporte para idiomas con diferentes escrituras, estructuras gramaticales o sistemas fonéticos requiere cambios fundamentales, no simplemente más datos.
Algunos equipos intentan resolver el problema con generación de datos sintéticos, usando LLMs para crear ejemplos de entrenamiento en idiomas objetivo. Esto funciona para ejercicios gramaticales pero falla para cualquier cosa que requiera expresión humana auténtica: el análisis de sentimientos, la IA conversacional y el reconocimiento de voz se degradan significativamente cuando se entrenan solo con datos sintéticos.
Construir una estrategia de datos multilingüe
Las empresas que aciertan con la IA multilingüe siguen un guion diferente:
Empieza con los mercados que realmente atiendes. Si tu producto se lanza en Vietnam, invierte en datos de voz y texto en vietnamita antes de expandirte al español. La priorización basada en el mercado supera siempre al orden alfabético o por tamaño de población.
Recopila datos nativos, no traducidos. Cada oración, cada muestra de audio debe provenir de un hablante nativo en un contexto natural. Esto significa trabajar con comunidades locales, no con proveedores de traducción.
Planifica los dialectos desde el primer día. Presupuesta la diversidad dialectal como un requisito central, no como un caso marginal. El costo de recopilar datos específicos por dialecto por adelantado es mucho menor que el costo de reentrenar un modelo que falla en producción.
Asóciate con proveedores que tengan redes locales. La parte más difícil de la recolección de datos de bajos recursos no es la tecnología, sino encontrar y gestionar hablantes nativos en diferentes geografías. Un proveedor con redes de anotadores establecidas en tus idiomas objetivo entregará mejores datos más rápido que cualquier solución basada en herramientas.
Las empresas que ganarán en la IA global no serán las que tengan los modelos más grandes. Serán las que tengan los datos más representativos. Y eso comienza con invertir en los idiomas que todos los demás están ignorando.
Puntos clave
- El 98,6% de los más de 7.000 idiomas del mundo carece de datos de entrenamiento IA suficientes
- Datos traducidos ≠ datos nativos — los modelos entrenados con traducciones pierden matices culturales
- La diversidad dialectal requiere flujos de datos separados, no soluciones universales
- La priorización basada en mercados supera al orden por población o alfabético
Contacta con Smart Language Service para recolección de datos multilingüe adaptada a tus mercados objetivo →