
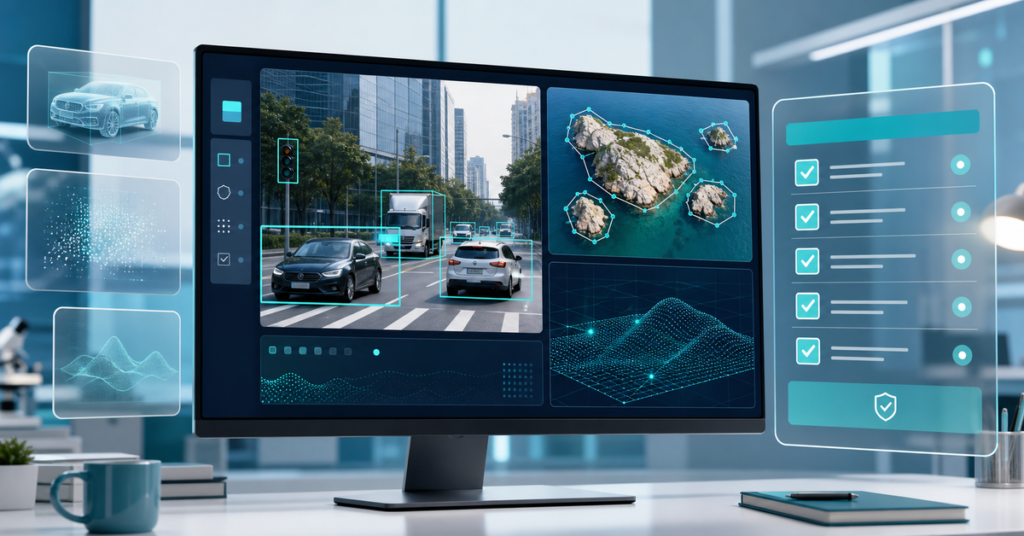
Por qué la anotación de imágenes para visión por computadora afecta más al modelo de lo que muchos compradores esperan
Muchos equipos tratan la anotación de imágenes para visión por computadora como una tarea de ejecución, pero para compras y operaciones es una decisión de diseño del modelo. El formato de anotación determina qué puede aprender el modelo, cómo medirán la calidad los revisores y cuánto retrabajo aparecerá después del entrenamiento. Un dataset con geometría incorrecta, reglas de clase débiles o manejo inconsistente de casos límite puede parecer completo y aun así limitar el rendimiento real.
Por eso no conviene elegir el formato solo por precio o familiaridad con una herramienta. Cajas delimitadoras, polígonos, polilíneas, keypoints y máscaras de segmentación sirven a objetivos distintos. La elección correcta depende de si el proyecto resuelve detección de objetos, segmentación fina, inspección de defectos, comprensión de escenas, conducción autónoma, análisis de estanterías u otro caso de uso de visión por computadora.
Para compradores y responsables de operaciones, la meta práctica no es pedir el nivel máximo de detalle, sino el nivel de precisión que el modelo realmente necesita y un flujo de QA capaz de mantener esa precisión en grandes volúmenes. Es la misma lógica operativa que sostiene un buen control de calidad en anotación de datos y unas guías de anotación claras: el formato elegido y la disciplina del workflow deben apoyarse mutuamente.
Empiece por el objetivo del modelo antes de elegir el tipo de anotación
Un error habitual en anotación de imágenes para visión por computadora es escoger primero el formato y justificarlo después. La secuencia más sólida es definir antes la tarea del modelo, los fallos esperados y el estándar de evaluación, y solo entonces decidir cómo se etiquetarán las imágenes.
Si el proyecto entrena un detector para inventario, tráfico o presencia general de objetos, las cajas pueden bastar. Si el modelo debe entender límites exactos, como en imagen médica, detección de defectos, segmentación documental o robótica avanzada, pueden ser necesarios polígonos o máscaras. Si el proyecto depende de puntos anatómicos, rasgos faciales o posiciones de componentes, los keypoints pueden ser más importantes que cajas o polígonos.
Esta decisión también afecta coste y productividad. Cuanto más detallada sea la anotación, más tiempo, más revisión y más complejidad documental requerirá. Por eso el comprador debe preguntar no solo qué desea el equipo de ML, sino qué nivel de detalle mejorará materialmente el resultado. La precisión extra que el entrenamiento no aprovechará puede elevar el presupuesto sin elevar el valor del dataset.
Cuándo las cajas delimitadoras son la opción correcta
Las cajas siguen siendo uno de los formatos más comunes en anotación de imágenes para visión por computadora porque son eficientes, escalables y muchas veces suficientes para tareas de detección. Funcionan bien cuando el modelo necesita localizar y clasificar un objeto dentro de un área razonable. Productos en estanterías, vehículos en carretera, paquetes en almacenes y personas en escenarios de seguridad son ejemplos típicos.
Las cajas son especialmente útiles cuando el borde exacto del objeto es difuso, cuando la acción posterior depende solo de la ubicación aproximada o cuando el dataset debe crecer rápido sobre grandes volúmenes. También son más rápidas de revisar que los polígonos densos, porque el revisor puede comprobar clase, posición y tamaño con mayor velocidad.
Sin embargo, tienen límites claros. Incluyen píxeles de fondo, se solapan mucho en escenas densas y funcionan mal con formas irregulares o muy finas. Objetos como cables, herramientas, tallos o bordes dañados pueden arrastrar demasiado ruido con una caja. Si el modelo necesita distinguir contornos precisos, la caja deja de ser un atajo útil y puede convertirse en una señal de entrenamiento demasiado débil.
Cuándo los polígonos o las máscaras justifican el esfuerzo adicional
Los polígonos y las máscaras de segmentación exigen más trabajo, pero suelen ser la inversión correcta cuando la forma del objeto importa. En anotación de imágenes para visión por computadora, esto ocurre con defectos de superficie, estructuras médicas, regiones agrícolas, elementos cartográficos, daños de embalaje o componentes industriales con contornos irregulares.
Un polígono ofrece una geometría mucho más ajustada que una caja, y una máscara puede representar el objeto a nivel de píxel. Esto mejora la calidad del dato para modelos de segmentación y reduce el ruido de fondo que el modelo podría aprender por accidente. Para equipos que miden cobertura de área, cambios de forma, superposición o separación fina entre objetos, esta precisión suele ser necesaria y no opcional.
La contrapartida es operativa. Las anotaciones detalladas aumentan el riesgo de desacuerdo sobre bordes, oclusiones, reflejos, sombras, transparencias y objetos parcialmente visibles. Si las instrucciones son débiles, el dataset se vuelve más caro sin volverse más consistente. Quien elige geometría detallada debería planificar desde el inicio calibración más estricta, menor throughput y más controles por muestreo.
Las etiquetas de atributos, las reglas de oclusión y la definición de clases importan tanto como la geometría
Muchos datasets fallan porque el equipo se concentra en la herramienta de dibujo y no en la lógica de etiquetado. La anotación de imágenes para visión por computadora necesita reglas claras para clases, oclusión, truncamiento, umbrales de visibilidad y casos difíciles. Dos anotadores pueden dibujar cajas muy parecidas y aun así discrepar sobre si el objeto debe etiquetarse, qué clase corresponde o cómo tratar una visibilidad parcial.
Una guía sólida debe definir cuándo un objeto es demasiado pequeño para etiquetarlo, cuándo el motion blur invalida el caso, cómo tratar objetos solapados y si los objetos reflejados o impresos cuentan como objetivos reales. Cuando proceda, también debe incluir atributos como dañado frente a intacto, abierto frente a cerrado, ocupado frente a vacío o contexto diurno frente a nocturno.
Aquí el comprador debe pedir ejemplos operativos, no promesas genéricas de dominio de herramientas. Si el proveedor no puede explicar cómo resuelve los casos límite, el equipo de modelo terminará invirtiendo más tiempo en corregir ambigüedad del dataset que en mejorar el modelo. La lección se parece a la de la recopilación de texto multilingüe para evaluación de LLM: la calidad depende de una especificación realista, no solo del volumen.
El QA en anotación de imágenes para visión por computadora debe ser por capas
Una auditoría final no basta en proyectos grandes de anotación de imágenes para visión por computadora. Cuando la revisión final detecta un patrón repetido de errores, es posible que ya haya miles de etiquetas que corregir. Un workflow más sólido combina lotes piloto, calibración de revisores, muestreo aleatorio, muestreo dirigido y ciclos de feedback basados en incidencias.
Los pilotos deben probar tanto la geometría como la claridad de las instrucciones escritas. La calibración de revisores debe comparar cómo distintos revisores interpretan las mismas imágenes ambiguas. El muestreo aleatorio ayuda a estimar la calidad global, mientras que el muestreo dirigido se enfoca en objetos pequeños, escenas densas, clases nuevas o grupos con menor desempeño.
Las métricas útiles van más allá de aprobado o rechazado. Conviene revisar tasas de confusión entre clases, porcentaje de corrección del revisor, frecuencia de objetos omitidos, errores de ajuste de caja o de borde de máscara y diferencias de tiempo por tipo de clase. Cuando esas métricas se conectan con ejemplos y con cambios documentados de guía, la calidad deja de ser subjetiva y se vuelve operable.
Qué debería preguntar el comprador antes de aprobar a un proveedor de anotación visual
Antes de iniciar el proyecto, conviene plantear preguntas operativas que revelen si el proveedor puede controlar la consistencia a escala.
- ¿Qué tipo de anotación recomiendan para el objetivo exacto del modelo y por qué?
- ¿Cómo documentan definiciones de clase, reglas de oclusión y umbrales mínimos?
- ¿Qué proceso piloto utilizan para ajustar la guía antes de la producción completa?
- ¿Cómo se revisan y resuelven los desacuerdos en bordes de polígonos o máscaras?
- ¿Qué métricas de QA siguen además de la precisión global?
- ¿Cómo se escalan las imágenes difíciles y cómo se comunican las actualizaciones de reglas?
- ¿Qué porcentaje del trabajo se vuelve a revisar en clases de alto riesgo?
Estas preguntas importan porque la anotación de imágenes para visión por computadora no es solo una tarea de escalar mano de obra. Es un sistema controlado de producción de datos. Los proveedores que pueden explicarlo con claridad suelen estar mejor preparados para sostener un desarrollo de modelo estable.
Cómo ayuda Smart Language Service en anotación de imágenes para visión por computadora
Smart Language Service apoya proyectos de anotación de imágenes para visión por computadora con diseño práctico de workflow, soporte operativo multilingüe, calibración de revisores y QA medible. Ayudamos a elegir el nivel de anotación adecuado para el objetivo del modelo, preparar instrucciones claras, gestionar casos límite y mantener calidad en grandes volúmenes.
Para equipos que construyen datasets de detección, segmentación, inspección, retail, robótica y otros casos de visión, la pregunta clave no es si la anotación puede completarse. La pregunta clave es si el dataset conservará suficiente consistencia como para mejorar el modelo de verdad. Cuando el tipo de anotación, la calidad de la guía y el diseño de QA se alinean desde el inicio, la anotación de imágenes deja de ser una fuente de retrabajo y se convierte en un activo para el modelo.