
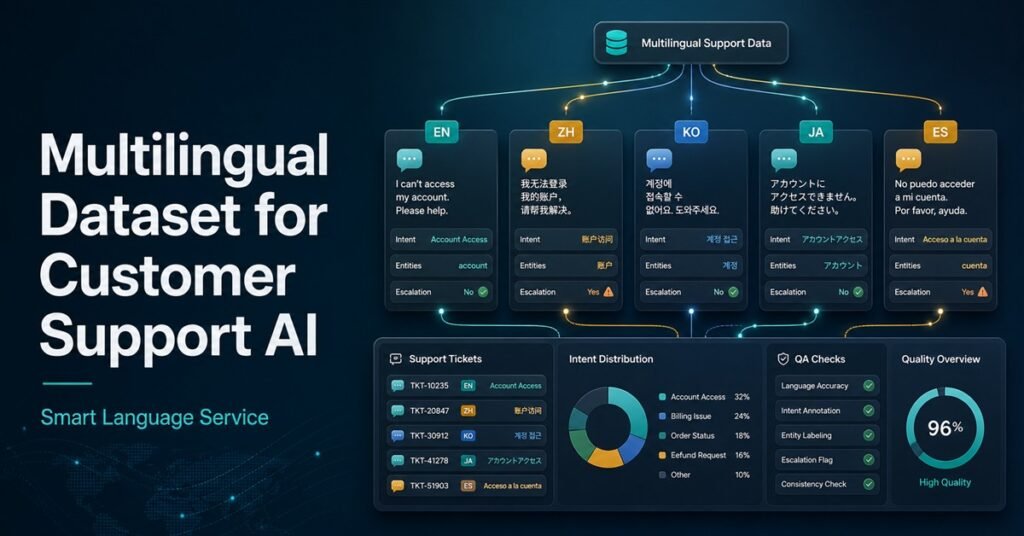
Por qué un dataset multilingüe para IA de atención al cliente necesita más que ejemplos traducidos
Un dataset multilingüe para IA de atención al cliente no debería construirse traduciendo una lista de intents en inglés y dando el proyecto por terminado. Los clientes reales no escriben como plantillas traducidas. Usan nombres locales de producto, errores de escritura, mezcla de idiomas, abreviaturas, quejas, señales de urgencia y formas de pedir ayuda propias de cada mercado. Si el dataset no refleja esos patrones, el modelo puede parecer preciso en pruebas internas y fallar en conversaciones reales.
Esto afecta a chatbots, enrutamiento de tickets, asistentes de voz, búsqueda en bases de conocimiento, agent assist, análisis de sentimiento y monitoreo multilingüe de calidad. La IA de soporte se evalúa en momentos de fricción: cuando el usuario está confundido, molesto, apurado o describe un problema con información incompleta.
Empiece por el workflow de soporte
El mejor punto de partida no es la lista de idiomas, sino el workflow que la IA debe mejorar. ¿Debe enrutar tickets, responder preguntas frecuentes, detectar riesgo de churn, resumir conversaciones, recomendar respuestas al agente o decidir cuándo escalar a una persona? Cada objetivo necesita datos distintos.
La clasificación de intents requiere expresiones representativas y etiquetas claras. El agent assist necesita mensajes de cliente, contexto y patrones de respuesta útiles. La detección de escalamiento necesita ejemplos de frustración, urgencia, contacto repetido, problemas de pago, riesgos de seguridad o solicitudes sensibles.
Defina intents, entidades y etiquetas de escalamiento
Los intents son la columna vertebral de muchos datasets de soporte. Pero una etiqueta demasiado amplia o solapada reduce el valor del dato. Problema técnico puede no bastar si el equipo necesita separar fallo de inicio de sesión, error de carga de archivos, permisos de cuenta o caída de API.
Las entidades también importan: nombres de producto, pedidos, tipos de cuenta, regiones, modelos de dispositivo, códigos de error, planes y fechas deben capturarse de forma consistente. Las etiquetas de escalamiento ayudan a marcar amenazas de reembolso, problemas legales, riesgos de seguridad, tono enfadado o impacto urgente en el negocio.
Recopile ejemplos nativos, no solo traducciones
La traducción ayuda a ampliar ejemplos iniciales, pero no debería ser la única fuente. Los ejemplos traducidos suelen conservar la estructura del idioma origen. Pueden ser correctos y aun así sonar poco reales.
La recopilación nativa aporta lenguaje informal, errores comunes, modismos locales, estilo de cada canal, abreviaturas, patrones de cortesía y señales de frustración. También muestra qué problemas son realmente frecuentes en cada mercado.
Incluya lenguaje imperfecto y QA desde el principio
La IA de soporte suele fallar cuando los datos son demasiado limpios. Los usuarios escriben con errores, cambian de idioma, pegan códigos, repiten mensajes, usan jerga, omiten contexto o envían frases breves como no funciona, sigo esperando o por qué me cobraron dos veces.
El control de calidad no debe esperar al final. Un dataset multilingüe para IA de soporte necesita QA en diseño de intents, recopilación, anotación, revisión y validación final. Las categorías sensibles como reembolsos, pagos, acceso a cuenta, seguridad y quejas legales necesitan muestreo dirigido.
Smart Language Service ayuda a construir datasets multilingües para IA de atención al cliente combinando texto, voz, transcripción, anotación, traducción y QA.