
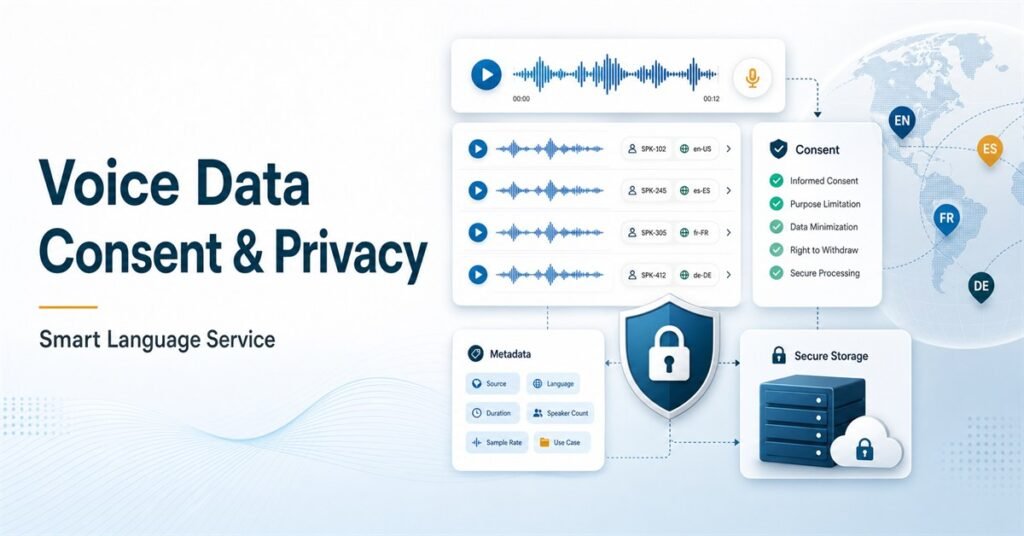
音声データ収集で同意が重要な理由
音声データ収集は、音声認識、音声アシスタント、通話分析、会話型 AI を構築するうえで重要です。しかし音声は単なるデータ形式ではありません。録音には言語、アクセント、年齢層、場所の手がかり、背景環境、健康状態、感情、ときには氏名などの個人情報が含まれる可能性があります。そのため、同意とプライバシー設計は事務的な作業ではなく、プロジェクト設計の中核です。
購入者にとって大きなリスクは、まず音声を収集し、あとからコンプライアンスを整理できると考えることです。実際には、同意文、参加者記録、保存ルール、匿名化、削除手順を募集前に定義する必要があります。これらが不明確だと、データセットは使用しにくく、監査しにくく、規制のある業務環境でモデル学習に使いにくくなります。
データセットの目的から始める
良い音声データ収集は、明確な用途から始まります。ASR 学習用の読み上げ音声なのか、対話システム用の自然会話なのか、コールセンター分析用音声なのか、デバイスのウェイクワード録音なのかによって、同意書、参加者説明、メタデータ、レビュー方法が変わります。
同意文には、何を録音するのか、なぜ収集するのか、データがどのように使われる可能性があるのか、AI モデル学習に使われるのか、処理担当者やレビュー担当者、技術パートナーと共有されるのかを説明する必要があります。参加者が自分の音声の用途を推測しなければならない状態は避けるべきです。
参加者の権利を明確にする
良い同意は具体的で分かりやすく、追跡可能であるべきです。参加者は撤回できるか、いつまで撤回できるか、誰に連絡すればよいか、すでに処理された録音がどう扱われるかを知る必要があります。未成年者、従業員、契約者、医療文脈、敏感な話題が含まれる場合は、追加の保護措置が必要になることがあります。
購入者は、同意記録がどのように保存されるかも確認すべきです。信頼できる同意文書がないデータセットはリスクになります。各録音は有効な同意記録に紐づけられる必要がありますが、アノテーションやレビュー担当者に不要な個人情報を見せるべきではありません。
収集するメタデータを管理する
メタデータは音声 AI プロジェクトに役立ちます。言語、方言、年齢層、性別、デバイス種類、録音環境、地域情報は、データカバレッジやモデル性能を評価するために有用です。しかし詳細すぎるメタデータは、識別可能な情報と組み合わさることでプライバシーリスクを高めます。
実用的な原則は、プロジェクト目的に必要なメタデータだけを収集することです。都市レベルの位置情報が不要なら、地域レベルで十分な場合があります。正確な年齢が不要なら、年齢層のほうが安全です。購入者とベンダーは募集前にメタデータ設計を合意するべきです。
保存、アクセス、セキュリティを計画する
音声録音は、明確なアクセス権限を持つ管理されたシステムに保存されるべきです。購入者は、誰が生音声にアクセスできるのか、誰が文字起こしにアクセスできるのか、誰がファイルをエクスポートできるのか、アクセスログがどう記録されるのかを確認する必要があります。越境プロジェクトでは、保存場所やデータ移転ルールも重要です。
セキュリティ計画には、暗号化、アクセス制限、安全な転送、保存期間、削除ルールを含めるべきです。参加者が撤回した場合やプロジェクト終了時の処理も定義する必要があります。これらは初日から設計に組み込むほど管理しやすくなります。
匿名化と削除には現実的な期待が必要
音声データは完全に匿名化することが難しい場合があります。声そのものが識別性を持つ可能性があるためです。文字起こしから氏名を削除することは有用ですが、生音声が匿名になったことを意味しません。プロジェクトによっては、個人情報の削除、話者 ID の分離、敏感な区間の削除が必要になります。
購入者は、期待する匿名化レベルと技術的に実現可能な範囲を明確にする必要があります。ベンダーは、削除や匿名化が音声、文字起こし、メタデータ、またはそのすべてに適用されるのかを説明するべきです。
音声データベンダーに確認すべきこと
プロジェクト開始前に、購入者はどの同意テンプレートを使うのか、参加者をどう募集し検証するのか、同意記録を録音にどう紐づけるのか、どのメタデータを収集するのか、データはどこに保存されるのか、誰がアクセスできるのか、撤回はどう処理されるのか、録音が同意範囲とプロジェクト要件に合っているかをどう確認するのかを質問するべきです。
これらは単なる法務上の形式ではありません。データセットを信頼、再利用、監査できるか、そして不要な遅延なく納品できるかを左右します。
Smart Language Service の支援
Smart Language Service は、データの有用性、同意、プライバシー、運用管理のバランスを取った音声データ収集ワークフローを支援します。参加者募集、多言語プロジェクト説明、メタデータ設計、録音品質確認、文字起こし、アノテーション、データセット検証に対応します。
複数言語や複数市場で音声 AI を構築するチームにとって、プライバシーを意識した事前設計はリスクを減らし、データセットの信頼性を高めます。同意とデータ処理ルールがワークフローに組み込まれていれば、購入者はより速く、より安心してプロジェクトを進められます。