
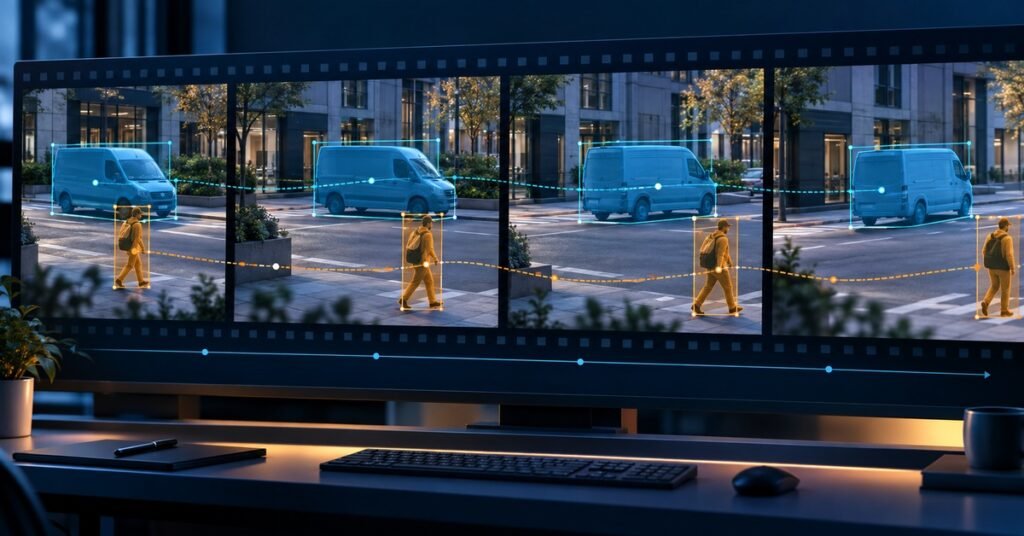
ラベル数ではなくモデルの目的で動画アノテーションサービスを選ぶ
動画アノテーションサービスは、連続フレームを、位置だけでなく同一物体の識別、動き、出来事の時間関係を保った学習データへ変換します。購入側は、モデルが物体を検出するのか、同一個体を追跡するのか、姿勢を推定するのか、輪郭を分割するのか、動作やイベントを認識するのかを最初に決め、その証拠を与える最も簡潔なアノテーションを選ぶべきです。動画を無関係な静止画の集合として扱うと、動画を使う理由である時間情報が失われます。
したがって、商用比較は1フレーム当たりの価格だけでは不十分です。実行可能な仕様には、作業単位、フレーム抽出、物体ID、遮蔽と再出現、補間、オントロジー、出力形式、品質指標、受入試験を含めます。ID修復や形式変換が多い安価なラベルは、設計された運用サービスより最終コストが高くなる場合があります。
本ガイドでは、コンピュータビジョン、ロボティクス、小売、モビリティのチームが、手法、フレームとシーケンス、時間的一貫性、ツールと形式、コスト要因、パイロット結果を比較する方法を説明します。
アノテーション種別をモデル出力に合わせる
同じ動画から複数の有効なデータセットを作れますが、答える問いは異なります。
- フレーム/クリップ分類は、フレームや区間に正常・異常、会計開始、フォークリフト稼働、運転操作などのカテゴリを付けます。位置が不要なら効率的ですが、動作の開始と終了を定義します。
- バウンディングボックスは矩形で個体を定位し、検出と多くの追跡に適します。遮蔽時に可視部分だけを囲むか、物体全体を推定するか指定します。
- オブジェクトトラックは複数フレームの同一個体を安定したIDで結びます。多物体追跡、軌跡、滞在時間、相互作用に使われ、IDスイッチとトラック分断が重要な欠陥になります。
- ポリゴン/インスタンスマスクは輪郭を描き、精密な空間推論、ロボット、産業検査、重なった物体の分離に有効です。時間とともに境界が変わるため工数が増えます。
- セマンティックセグメンテーションは関連画素にクラスを付け、インスタンスセグメンテーションは個々の物体を分離します。パノプティック方式も含め、学習系が期待する表現を明記します。
- キーポイント/スケルトンは関節、工具先端、車輪、製品角などを示します。点の順序、左右、可視性の規則が必要です。
- 行動、イベント、時間区間は開始、終了、主体、関係を記録します。商品の持ち上げ、車線変更、立入禁止区域への進入などの境界許容差をフレーム数または時間で定義します。
Microsoft COCO論文は物体検出とインスタンス分割の一次資料であり、BDD100K論文は一つの動画コレクションが検出、レーン、セグメンテーション、多物体追跡など異種タスクを支えられることを示します。つまり「動画アノテーション」は一つの納品物ではなく、購入側がタスクと表現を指定しなければなりません。
多層ラベルは下流価値がある場合に限ります。小売では人物トラック、棚領域、商品取得イベントが必要でも、全人物の画素マスクは不要かもしれません。ロボットでは操作対象だけにマスクとキーポイントを付け、背景はセマンティック領域で十分な場合があります。
フレーム単位とシーケンス単位を決める
最初の範囲判断は、フレームを独立サンプルとするか、追跡シーケンスの一部とするかです。
静止画を入力とするモデル、時間順序の価値が小さいケース、多様なスナップショットを意図的に選ぶ場合には独立フレームが適します。並列作業と画像形式への出力も容易です。ただし一定間隔だけで抽出すると、近似フレームが過剰になり、短いイベントを逃し、同じ物体に不整合なIDが付くおそれがあります。
個体識別、移動、持続時間、遷移、相互作用が重要ならシーケンスで処理します。完全なクリップまたは明確なショットを単位とし、進入、退出、遮蔽、再出現、カットをまたぐ場合の規則を設けます。評価基準と同じID判断を行えるよう、前後文脈を作業者に提示します。
予測可能な動きではキーフレーム補間が反復作業を減らします。CVATの公式用語資料は、動画の補間モードでtrackオブジェクトを使い、キーフレーム間の形状を線形補間すると説明しています。ポリゴントラック資料は、始点と方向の一貫性も必要だと示します。自動化は加速手段であり、受入証拠ではありません。高速移動、変形、カット、遮蔽、スケール変化では追加キーフレームや手動修正が必要です。
固定間隔、シーン変化、重要イベント周辺の密な抽出、小物体、強い遮蔽、低照度、天候、珍しい視点のリスク抽出を組み合わせます。同一シーケンスの隣接フレームは同じ訓練・検証・テスト分割に置きます。そうしないと類似画像が分割をまたいで漏れ、実運用より評価が良く見えます。
時間的一貫性を受入要件にする
一つのフレームでボックスが正しくても、トラック全体は間違う可能性があります。動画QAは空間精度と連続性を同時に確認します。
一つのトラックIDは一つの物理的個体に保ちます。二つの物体が交差するときは、接近、重なり、分離の全区間をレビューします。遮蔽後にIDを再開する条件と、新規トラックにする条件を定め、形式が使うなら「遮蔽」「画面外」「場面に不在」を区別します。
幾何ルールも必要です。対応する物体またはカメラ移動がないのに、ボックスやマスクが揺れてはいけません。可視画素だけ、不可視部分を含む推定形状、クラス固有方式のいずれかを一貫して適用します。補間形状はキーフレームだけでなく、中間点と動きの変化点も確認します。
クラス、色、装置種別などの恒常属性は不用意に変化させません。姿勢、可視性、動作、信号状態などの可変属性には許容遷移が必要です。イベントは「手が対象に初めて接触した時点で開始し、対象を制御した時点で終了」のように起点と終点を記述し、数値の許容差を設けます。
レポートは、フレーム幾何一致度、クラス・属性精度、トラック完全性、断片化、IDスイッチ、イベント境界、見逃し、スキーマと出力検証を分けて示します。小さな安全対象では平均IoUより見逃しが重要で、軌跡モデルでは多少緩い箱を許してもIDスイッチを拒否する場合があります。タスク別の閾値と、意見差の裁定、修正後の回帰確認を要求します。
コンピュータビジョン向け画像アノテーションと手戻りを減らすガイドラインも、形状とエッジケース設計に利用できます。
本番前にツール、オントロジー、形式を確定する
ツールについて、長尺動画、フレーム移動、再生速度、キーフレーム、補間、トラックID、遮蔽状態、マスク、キーポイント、時間区間、コメント、監査履歴、権限、レビューキューを確認します。代表的な解像度、コーデック、フレームレート、長さで動作を試します。機能一覧だけでは本番素材での操作性を証明できません。
オントロジーと手順書を一緒に版管理します。各ラベルには定義、包含・除外、正例・負例、階層、属性、難例方針を用意します。切れ、群衆、反射、画面、影、小物体、モーションブラー、重複、カット、不確実フレームを扱い、パイロットで新しい問題が出れば決定ログを更新します。
初回作業前に、座標原点と単位、丸め、フレーム番号とタイムスタンプ、可変フレームレート、元動画チェックサム、クラス・トラック・アノテーションID、ポリゴン方向、マスク符号化、キーポイント順、可視性、イベント区間、フォルダ構成と版履歴を設計します。
COCO型JSONは画像検出、分割、キーポイントで一般的ですが、動画ID設計を自動的に解決しません。ツール固有形式はトラックを保ってもロックインを招き、独自JSONはパイプラインに合っても検証負担が増えます。マルチセンサーとシナリオでは、物体、フレーム、ストリーム、座標系、行動、イベント、関係を扱う ASAM OpenLABEL を参照できます。名前の知名度ではなく、実際のローダーで検証可能な形式を選びます。
調達時に出力サンプルを入手し、訓練ローダーで読み、ランダムに可視化し、件数とIDを確認します。スキーマ有効でも座標方式や時間的IDが誤っていることがあります。
実際のコスト要因を理解する
動画時間だけでなく、アノテーションイベントとレビューの複雑さがコストを決めます。1分の固定インタビューと1分の混雑交差点は同じ長さでも物体数と動きが大きく異なります。
有効フレーム数、フレーム当たり物体数、トラック長、進入・退出、遮蔽密度、形状タイプ、クラス・属性・関係数、解像度とフレームレート、補間や事前ラベルの修正量、希少クラス探索、専門性、セキュリティ、レビュー・裁定・修正、変換とレポートが主な要因です。
見積もりはフレーム単価より、受入済みシーケンス当たりコストなどの検証単位で比較します。各候補に同じサンプル、オントロジー、出力、QA計画、閾値を渡し、準備、制作、レビュー、裁定、修正を分けて提示させます。
サービス範囲、提供モデル、ベンダー適合性をより広く精査する際は、AIデータサービス企業の比較を本ガイドの動画固有の証拠と併用してください。
A社が10フレームごとのボックスを低価格で提供するがID連続性を確認せず、B社がキーフレームトラック、予測可能な動きの補間、全遮蔽遷移のレビュー、IDスイッチ報告を提供するとします。モデルが軌跡を必要とするなら、Aは同じサービスの安価版ではなく、再ラベルまたは技術修復が必要な別の納品物です。
自動化の節約効果は修正時間と誤り分布で決まります。同じパイロットシーケンスで手動と支援方式を比較し、作業時間、レビュー、修正、受入量、条件別欠陥を記録します。サンプル根拠なしに一般的な生産性主張を予測へ使わないでください。
購買判断に答えるパイロットを実施する
良いパイロットは見栄えの良いデモではなく、縮小した本番システムです。通常素材に加え、混雑、高速移動、部分・完全遮蔽、カメラ移動、ブラー、小物体、クラス曖昧性、カット、希少イベントを含めます。購入側が管理するゴールドまたは裁定セットは制作担当者から隠します。
開始前に、モデルタスク、素材の権利とセキュリティ、シーケンスと抽出、オントロジー、ID・遮蔽・形状・イベント規則、正しい出力例、QAサンプルと閾値、エスカレーションと修正責任、レビュー後の処理量、変更・再見積もり規則を合意します。
実行中は工程別工数、受入アノテーション、エラー分類、ID欠陥、質問応答時間、ガイド変更、出力失敗、評価者一致を測り、容易な映像と難しい映像を分けます。空フレームと密集場面を混ぜた平均値は拡大根拠になりません。
終了時に、最終アノテーション、検証済み出力、問題ログ、修正版ガイド、決定ログ、QAレポート、拡大前提を受け取り、複数の完全なシーケンスを最初から最後まで確認します。その上で承認、仕様修正、第二パイロット、停止を決めます。
購入チェックリスト:
- 提案されたアノテーションがモデル出力を直接支えるか。
- 抽出とシーケンス境界が明確か。
- ID、遮蔽、再出現、カットの規則があるか。
- 包含規則と難例が例示されているか。
- ツールが時間誤差なく本番動画を扱えるか。
- 形式が実際の訓練ローダーを通ったか。
- 幾何、クラス、時間、スキーマ品質を別々に測るか。
- 価格にレビュー、裁定、修正、報告が含まれるか。
- アクセス、保持、削除が素材リスクに合うか。
- 処理量を難度別の受入成果で報告するか。
優れた動画アノテーションサービスは、ラベルをモデルタスクに結び付け、時間的意味を保ち、形式互換性を証明し、受入品質を価格化します。代表的な動画サンプルを Smart Language Service にお送りください。方式とコストの検討、パイロット設計、必要なオントロジーのローカライズ、制作・レビュー、シーケンス単位の受入証拠を支援します。