
なぜ3つのサービスを同じ会社でやっているのか
Smart Language Serviceは2020年から、字幕ローカライズ、AI向け音声データ収集・アノテーション、技術文書翻訳の3つの言語サービスを展開しています。
業界では「専門特化」が常識です。字幕は字幕のプロ、翻訳は翻訳のプロ。たしかに、それぞれの分野には固有のノウハウがあります。しかし、私たちはあえて複数領域を同時に手がける道を選びました。
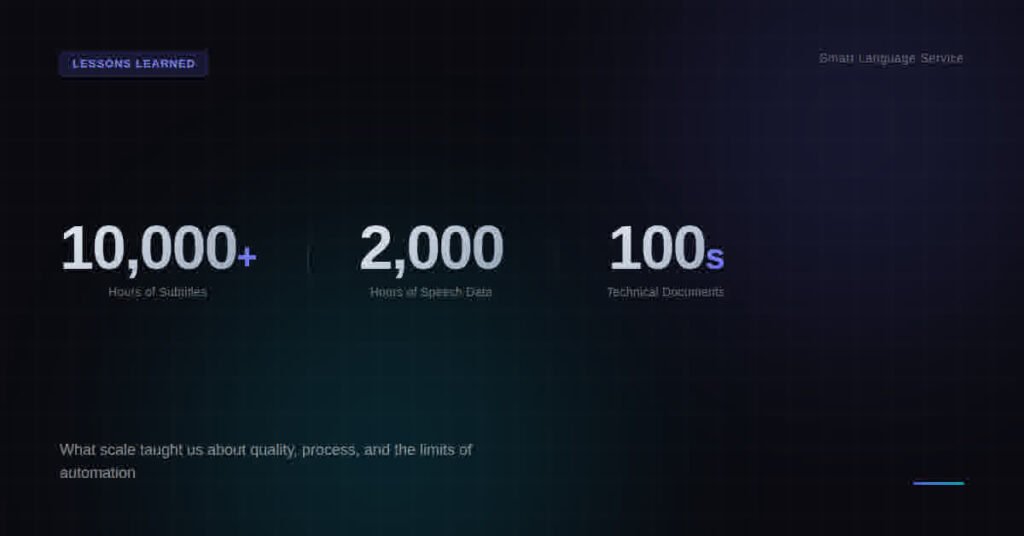
結果として、字幕10,000時間以上(Pixelogic向けハリウッド作品中心)、モロッコアラビア語音声データ2,000時間、数百件の技術文書を納品する実績が積み上がりました。
この記事では、3つの異なる言語サービスを一社で運営してきたからこそ見えた教訓を、具体的な数字と失敗談とともに共有します。
教訓1:「文脈の解像度」が品質の9割を決める
字幕ローカライズで最も多いミスは、翻訳の誤りではありません。文脈の読み違えです。
NetflixやCrunchyrollで配信される日本のアニメが世界的にヒットしています。2025年には『チェンソーマン』シーズン2や『呪術廻戦』続編が世界中で同時配信されました。こうした作品の字幕では、キャラクターの性格、関係性、シーンの雰囲気をすべて把握した上で、1行15文字前後に収める必要があります。
ある案件で、「I'm fine」というセリフを「大丈夫」と訳しました。文脈上、このキャラクターは怒りを抑えて言っている台詞だったのですが、平坦な「大丈夫」では感情が伝わりません。「別に」と訳すべきところでした。この種のミスは、レビューチェックリストだけでは防げません。作品全体への理解が必要です。
音声データ収集でも同じことが起きます。モロッコアラビア語(ダリジャ)の収集プロジェクトでは、単に「話してください」と言うだけでは、AI学習に使える自然な会話データは集まりません。会話のシナリオ設計、参加者の関係性設定、録音環境の統一——すべてが「文脈の解像度」に依存します。
教訓2:言語ペアによって納品構造を変える
英語→日本語と、アラビア語→英語では、品質管理のポイントが根本的に違います。
技術文書翻訳でいうと、英語→日本語の課題は冗長性です。英語の技術仕様書をそのまま日本語にすると、原文の1.3〜1.5倍の文字数になり、マニュアルのレイアウトが崩れます。一方で、日本語→英語では主語の補完が課題になります。「起動します」は誰が?何の条件で?
このため、私たちは言語ペアごとに品質チェック項目を変えています:
- EN→JA:文字数比率チェック、技術用語の統一辞書適用、敬語レベルの確認
- JA→EN:主語・目的語の明示化確認、受動態の多用チェック、数値単位の統一
- アラビア語系:RTL対応確認、数字表記(東アラビア数字/西アラビア数字)、宗教的配慮事項
日本のAI研究機関——Preferred NetworksやSakana AIのような組織が海外向けに論文やドキュメントを出す場合、単なる「翻訳」ではなく、英語圏の読者が違和感なく読める構造への書き換えが必要です。ここを見落とすと、技術的に正しい内容でも「読みにくいドキュメント」として信頼を損ないます。
教訓3:アノテーション品質は「最初の100件」で決まる
AI学習用データのアノテーションは、大量処理のイメージが強いですが、品質の成否は最初の100件でほぼ決まります。
モロッコアラビア語2,000時間のプロジェクトを振り返ると、初期の100件のアノテーションに2週間をかけました。ガイドライン策定→テストアノテーション→フィードバック→ガイドライン修正、を3サイクル回しています。この初期投資をケチると、後工程で数千件の手直しが発生します。
具体的に、最初の100件で固めるべき項目は:
- 発話区切り(VAD)の許容誤差範囲
- 方言コードの分類基準(ダリジャと現代標準アラビア語の境界)
- ノイズ環境のラベリング統一(背景音、重複発話)
- メタデータの粒度(話者属性、録音環境、話速カテゴリ)
2026年現在、日本のAI企業が音声AIモデルを独自開発するケースが増えています。大規模言語モデルだけでなく、音声認識や音声合成への投資が活発です。こうしたプロジェクトで最もコストがかかるのは、品質の不揃いなデータセットを後から修正する作業です。最初の100件への投資は、プロジェクト全体の20%程度のコストで済みますが、これを省略すると後工程で60%以上のコストが修正に消えます。
教訓4:技術文書の翻訳で最もコストが高いのは「手戻り」
技術文書の翻訳プロジェクトで、納品後にクライアントから修正依頼が来るケース。これは翻訳品質の問題ではなく、要件定義の不足が原因のことがほとんどです。
実際にあった例:ある製造業クライアントの装置マニュアル翻訳で、「安全に注意してください」という文言を「Please pay attention to safety」と訳しました。クライアントのフィードバックは「CAUTION」のラベル表記にするべき、というもの。ISO規格に準拠した表記体系があり、それを事前に共有されていなかったのです。
この案件では、キックオフ時に以下の情報を必ず確認するようになりました:
- 対象読者の専門レベル(エンジニア/エンドユーザー/規制当局)
- 適用規格(ISO, IEC, JIS, 業界規格)
- 既存用語集とスタイルガイドの有無
- 図表・レイアウト制約(文字数制限、フォント指定)
- CMSや翻訳メモリの接続要件
手戻り1件のコストは、初回翻訳の3〜5倍です。キックオフに2時間かけるだけで、このコストをほぼゼロにできます。
教訓5:AI時代の言語サービスに求められる新しい能力
2026年の言語サービス業界で明確になっているのは、MTポストエディットだけでは差別化できないという事実です。
DeepLやGPT系の翻訳精度は、特定のドメインでは実用レベルに達しています。しかし、以下の領域では依然として人間の判断が不可欠です:
- 字幕:時間軸制約(1秒あたりの文字数)、読みやすさ、文化的配慮
- 音声データ:方言識別、感情ラベリング、発話意図の分類
- 規制文書:法的正確性、業界用語の適切な訳語選択
日本のコンテンツ産業が東南アジア展開を加速する中で、タイ語、インドネシア語、ベトナム語への字幕ローカライズの需要が急増しています。こうした言語ではMTの精度がまだ追いついておらず、人間の翻訳者による品質保証が必須です。一方で、英語や中国語ではMT+ポストエディットのワークフローが標準化されつつあります。
言語サービスベンダーに求められるのは、「MTで十分な領域」と「人間が必要な領域」を正確に切り分ける能力です。すべてを人手でやるのはコスト過多、すべてをMTに任せるのは品質リスク。このバランス設計こそが、2026年の言語サービスの付加価値です。
教訓6:一社で複数サービスをやるからこそ見える全体像
最後に、これは自社の選択を振り返っての所感です。
字幕、音声データ、技術文書。一見バラバラの3つのサービスですが、品質管理の根幹は同じです:文脈理解、用語統一、納品構造の設計。3つのサービスを横断的に手がけることで、ある領域で得た知見が別の領域に応用できる場面が頻繁にあります。
例を挙げます。字幕ローカライズで培った「文字数制約内での情報圧縮技術」は、技術文書のUIラベル翻訳にそのまま活かせます。音声データ収集で確立した「アノテーションガイドライン策定プロセス」は、翻訳メモリの品質管理フレームワークに応用できました。
専門特化型のベンダーが悪いわけではありません。しかし、クライアント側の課題は往々にして複数領域にまたがります。コンテンツのグローバル展開を考えている企業にとって、字幕・吹替用音声データ・マーケティング文書翻訳をワンストップで依頼できる体制は、プロジェクト管理コストを大幅に削減します。
まとめ:言語サービス選定で押さえるべき4つのポイント
10,000時間の字幕、2,000時間の音声データ、数百件の技術文書。これらを納品してきた経験から、言語サービス選定で最も重要なポイントを4つにまとめます。
- 初期設計への投資を惜しまない:最初の100件・最初の2時間のキックオフが、プロジェクト全体のコストを決定づけます。
- 言語ペアごとに品質基準を変える:一律のチェックリストでは、言語固有の品質課題に対応できません。
- MTと人間の役割分担を明確にする:すべて人手は高コスト、すべてMTは高リスク。適切なワークフロー設計が差別化要因です。
- ベンダーの「横断知見」を評価する:複数領域の実績があるベンダーは、単一領域のベンダーには見えない全体最適を提案できます。
Smart Language Serviceでは、字幕ローカライズ、AI学習データ収集・アノテーション、技術文書翻訳の3領域で実績を積んでいます。プロジェクトの規模や言語ペアに関わらず、初期設計段階から品質を担保する体制で対応しています。言語サービスの品質や効率化についてお困りの方は、お気軽にご相談ください。