
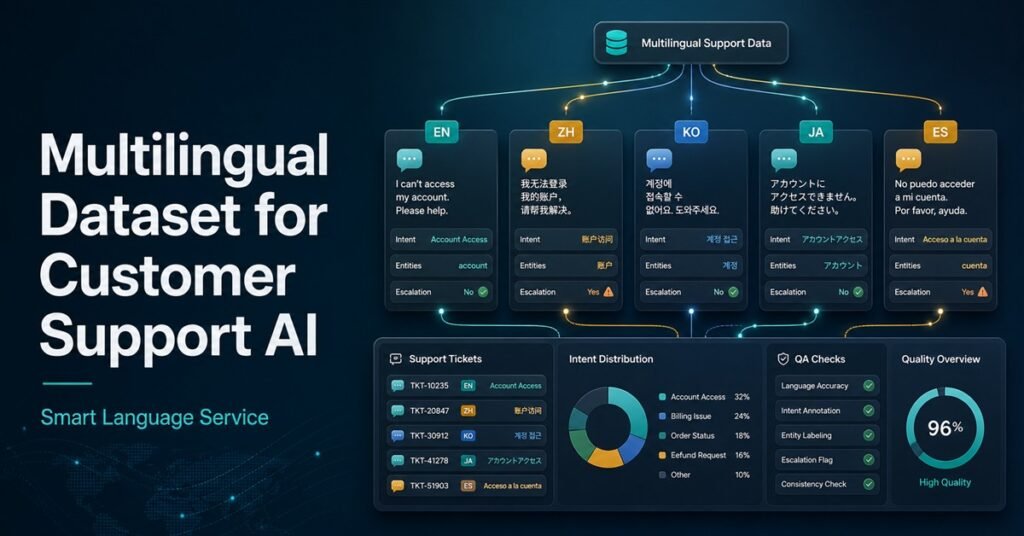
翻訳した例文だけでは足りません
カスタマーサポートAI向けの多言語データセットは、英語の意図リストを各言語に翻訳するだけでは十分ではありません。実際の顧客は翻訳テンプレートのようには話しません。現地の商品名、表記ゆれ、タイプミス、言語混在、短い不満、緊急性のある表現、市場ごとの問い合わせ習慣が含まれます。こうした要素がなければ、モデルはテストでは良く見えても実運用で弱くなります。
このデータセットは、チャットボット、チケット振り分け、ナレッジ検索、エージェント支援、感情分析、音声サポート、多言語品質管理に影響します。サポートAIは、顧客が困っている時、急いでいる時、怒っている時に評価されます。そのため、きれいな文章よりも実際の相談行動を反映する必要があります。
まずサポート業務を定義します
最初に決めるべきなのは言語リストではなく、AIがどの業務を改善するかです。チケットを正しいチームに送るのか、FAQに答えるのか、解約リスクを検出するのか、会話を要約するのか、担当者向け回答を提案するのか、人間へのエスカレーションを判断するのかで必要なデータは変わります。
意図、エンティティ、エスカレーションを設計します
ラベルが広すぎたり重なりすぎたりすると、データセットは実務で使いにくくなります。技術的な問題というラベルだけでは、ログイン失敗、アップロードエラー、権限問題、API障害を区別できないかもしれません。ラベルは実際のサポートアクションに合わせて設計する必要があります。
エンティティも重要です。商品名、注文番号、アカウント種別、地域、端末、エラーコード、プラン名、日付は一貫して扱う必要があります。多言語環境では、英語の商品名が日本語文に入る、略語が使われる、表記が揺れるといった現象も自然なデータとして扱うべきです。
翻訳だけでなくネイティブ表現を集めます
翻訳は初期サンプルの拡張には役立ちますが、それだけでは実際の顧客らしさが不足します。ネイティブ表現の収集により、口語、誤字、チャネルごとの言い方、丁寧さ、不満表現、地域特有の問い合わせ内容を取り込めます。
QAを最初から組み込みます
品質管理は最終納品だけでは遅すぎます。意図設計、言語収集、アノテーション、レビュー、最終検証の各段階でQAが必要です。初回バッチでラベル混乱や不自然な表現が見つかったら、大量作業の前にガイドラインを直すべきです。
Smart Language Serviceは、テキスト、音声、文字起こし、アノテーション、翻訳、QAを組み合わせ、カスタマーサポートAI向けの多言語データセット構築を支援します。