
Por qué importa el control de calidad en anotación de datos
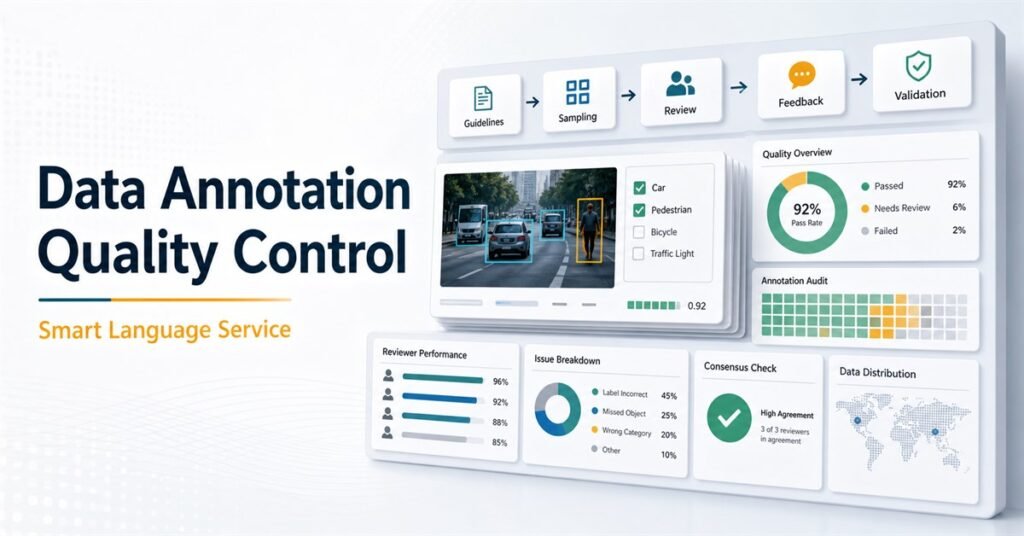
El control de calidad en anotación de datos es una de las partes más importantes para construir datos de entrenamiento útiles para IA. Un modelo solo puede aprender de la estructura, las etiquetas y los ejemplos que recibe. Si las etiquetas son inconsistentes, las guías son poco claras o los revisores solo comprueban el lote final, el proyecto puede parecer terminado aunque el conjunto de datos mantenga problemas ocultos.
Para los equipos de IA, la calidad de anotación no consiste solo en corregir errores individuales. Consiste en diseñar un flujo de trabajo que prevenga errores evitables, detecte casos ambiguos temprano y mantenga alineados a equipos grandes durante todo el proyecto. Esto es especialmente importante en proyectos multilingües, datasets especializados y tareas donde la definición de etiqueta depende del contexto.
La calidad empieza antes del etiquetado
Un proyecto estable empieza con un diseño claro de la tarea. Antes de asignar trabajo, el equipo debe definir la taxonomía de etiquetas, criterios de aceptación, casos límite, reglas de rechazo y ejemplos para cada etiqueta. Una buena guía no solo explica cuál es la respuesta correcta, sino por qué una etiqueta es preferible a otra en casos difíciles.
La anotación piloto también es esencial. Un lote piloto pequeño permite descubrir instrucciones ambiguas, etiquetas faltantes, ejemplos confusos y supuestos de productividad poco realistas. Si el piloto muestra desacuerdo entre anotadores, no es un fracaso. Es evidencia útil de que la guía debe mejorarse antes de escalar.
La calibración de revisores evita decisiones inconsistentes
La calibración de revisores suele pasarse por alto. Si los revisores aplican estándares distintos, el dataset final puede volverse inconsistente incluso cuando los anotadores trabajan con cuidado. Antes de la producción completa, los revisores deben anotar y revisar el mismo conjunto de muestra, comparar decisiones y acordar cómo manejar los casos difíciles.
La calibración debe continuar durante el proyecto. A medida que crece el dataset aparecen nuevos casos límite. Estos casos deben añadirse a la guía, no resolverse de forma privada por un solo revisor. Así se crea un sistema de calidad vivo donde cada decisión mejora el siguiente lote.
El muestreo y los ciclos de feedback reducen el retrabajo
Un flujo práctico de calidad debe combinar muestreo aleatorio, muestreo dirigido y revisión basada en incidencias. El muestreo aleatorio ofrece una visión general de la calidad. El muestreo dirigido se centra en etiquetas de alto riesgo, anotadores nuevos o tipos de contenido complejos. La revisión basada en incidencias rastrea errores repetidos y los convierte en feedback concreto.
La rapidez del feedback importa. Si los anotadores reciben comentarios solo después de completar miles de elementos, el mismo error puede haberse repetido en todo el dataset. Ciclos cortos de revisión ayudan a corregir la dirección temprano y reducen retrabajo costoso.
Las métricas deben apoyar decisiones, no ocultar problemas
Las tasas de precisión y acuerdo son útiles, pero no deben ser las únicas señales de calidad. Una tasa alta de acuerdo puede significar simplemente que la tarea era fácil, mientras que una tasa baja puede indicar guías ambiguas más que bajo rendimiento del anotador. Métricas útiles incluyen distribución de etiquetas, tasa de corrección por revisores, frecuencia de tipos de error, cambios de productividad y casos límite sin resolver.
El objetivo es entender por qué cambia la calidad. Cuando las métricas se conectan con ejemplos reales y notas de revisión, los responsables pueden decidir si actualizar guías, volver a formar anotadores, ajustar el alcance o añadir otra capa de revisión.
Cómo ayuda Smart Language Service
Smart Language Service ayuda a los equipos de IA a construir flujos de anotación prácticos, medibles y escalables. Apoyamos el diseño de guías, equipos multilingües de anotación, calibración de revisores, muestreo de calidad, gestión de feedback y validación final del dataset. Nuestra experiencia en servicios lingüísticos y datos de IA nos permite manejar tareas donde el idioma, el contexto y los matices culturales afectan la calidad de la etiqueta.
Para equipos que preparan datasets de voz, texto, imagen o datos multilingües, el control de calidad debe integrarse desde el inicio del proyecto. Cuando QA forma parte del flujo de trabajo y no solo del punto final, el dataset se vuelve más confiable y el proceso de entrenamiento del modelo es más fácil de validar.