
AI的语言鸿沟
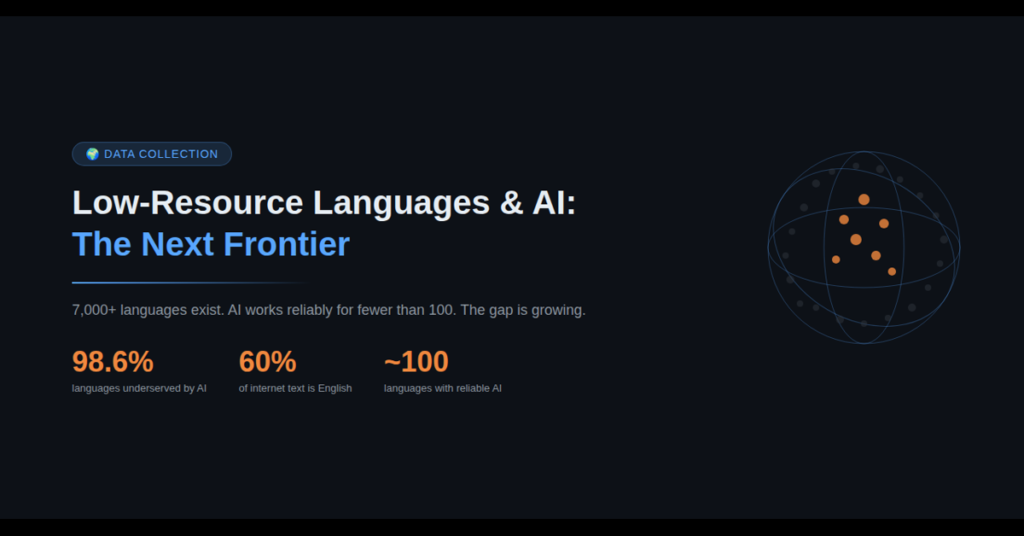
英语占据了互联网文本内容的约60%。而作为全球母语使用人数第二的中文,占比约为5%。至于斯瓦希里语——东非超过一亿人在使用的语言——在互联网数据集中几乎看不到踪影。
这种失衡在使用AI产品时随处可见:用阿姆哈拉语对语音助手说话得不到回应,用克丘亚语向聊天机器人提问时答非所问,对约鲁巴语的社交媒体内容做情感分析时结果完全不可信。问题不在算法本身,而在于训练数据根本不存在。
截至2026年,主流大语言模型在约100种语言上表现可靠,而全球有7000多种语言。这意味着98.6%的语言在AI世界中处于被忽视状态。对于布局新兴市场的企业来说,这不是学术问题,而是实打实的竞争盲区。
数据稀缺的根源
为低资源语言采集高质量训练数据,面临三个叠加的困难:
数字化内容匮乏。许多语言拥有丰富的口头传统,但在线书面语料极其有限。你可以在一个下午从网上抓取数十亿条英文句子,但提格里尼亚语或基切语可能只有几千份文档——其中很多还是从其他语言机翻过来的,根本无法用于训练。
标注人才难以获取。即使找到了原始数据,你还需要既懂这门语言又懂标注任务的母语者。一个能给法语做词性标注的语言学家,并不天然具备给班巴拉语做标注的能力。为小语种寻找和筛选标注人员,靠的是本地人脉网络,而不是众包平台。
方言问题让局面更加复杂。从AI的角度来看,"阿拉伯语"不是一种语言。摩洛哥方言、埃及阿拉伯语和海湾阿拉伯语在实际使用中互不相通。用现代标准阿拉伯语训练的模型,在处理突尼斯方言的客服电话时表现会很差。每种方言都需要独立的数据管道——而大多数方言几乎没有任何数据基础。
忽视小语种的业务代价
把语言支持当作事后补充的企业,正在承受可量化的损失:
某主流打车应用进入内罗毕市场时,纯英文语音界面迫使司机在驾驶过程中手动输入指令——这带来了安全隐患,也导致该市场的取消率比有本地语言语音支持的市场高出23%。后来该公司投入资源采集斯瓦希里语语音数据,司机留存率提升了18%。
在医疗领域,仅基于英文医学文献训练的诊断聊天机器人会遗漏症状描述中的文化语境。非洲数学科学院的一项研究发现,豪萨语和伊博语中的症状描述经常使用比喻性表达,直接翻译会完全丢失这些信息,导致初步诊断不准确。
在客服自动化方面,差距同样明显。Zendesk 2026年客户体验趋势报告显示,东南亚和撒哈拉以南非洲67%的消费者更偏好使用本地语言获得支持——但只有不到30%的企业级客服平台能在这些语言上提供可靠的自动化服务。
常见误区
我们最常看到的错误是:以为多语言支持就是把英文数据集翻译一遍。翻译保留的是词汇,不是说话习惯、文化参照和母语者自然的表达方式。用翻译数据训练的模型语法上没有问题,但文化上是外来的。
另一个常见错误是优先覆盖高资源语言,把低资源语言留到"第二阶段"。等第二阶段到来时,产品架构已经默认了类似英语的数据分布——要适配不同文字、语法结构或语音系统的语言,需要底层改动,不是多塞点数据就能解决的。
还有些团队试图用合成数据来解决问题——用大语言模型生成目标语言的训练样本。这对语法练习有用,但对需要真实人类表达的场景则远远不够:情感分析、对话式AI和语音识别如果仅靠合成数据训练,效果会显著下降。
构建多语言数据策略
在多语言AI上做得好的企业,走的是另一条路:
从你真正要进入的市场开始。如果你的产品要进入越南市场,先投资越南语的语音和文本数据,再考虑西班牙语。以市场需求为优先级的做法,永远优于按字母顺序或人口规模排序。
采集原生数据,而不是翻译数据。每一句话、每一段音频都应该来自母语者在自然场景中的表达。这意味着要和当地社区合作,而不是找翻译供应商。
从第一天就为方言做规划。把方言多样性纳入核心预算,而不是当作边缘情况处理。提前采集方言数据的成本,远低于模型上线失败后重新训练的费用。
和拥有本地网络的供应商合作。低资源数据采集最难的环节不是技术,而是在不同地区找到和管理母语者。在你的目标语言地区有成熟标注网络的供应商,比任何工具化的替代方案都能更快交付高质量数据。
在全球AI竞争中胜出的,不会是模型最大的公司,而是数据最有代表性的公司。而这一步,从投资那些被所有人忽视的语言开始。
核心要点
- 全球7000多种语言中,98.6%缺乏足够的AI训练数据
- 翻译数据不等于原生数据——基于翻译训练的模型会丢失文化细节
- 方言多样性需要独立的数据管道,不能一套方案通吃
- 以市场进入优先级驱动语言选择,优于按人口或字母排序
联系智语服务,为您的目标市场定制多语言数据采集方案 →