
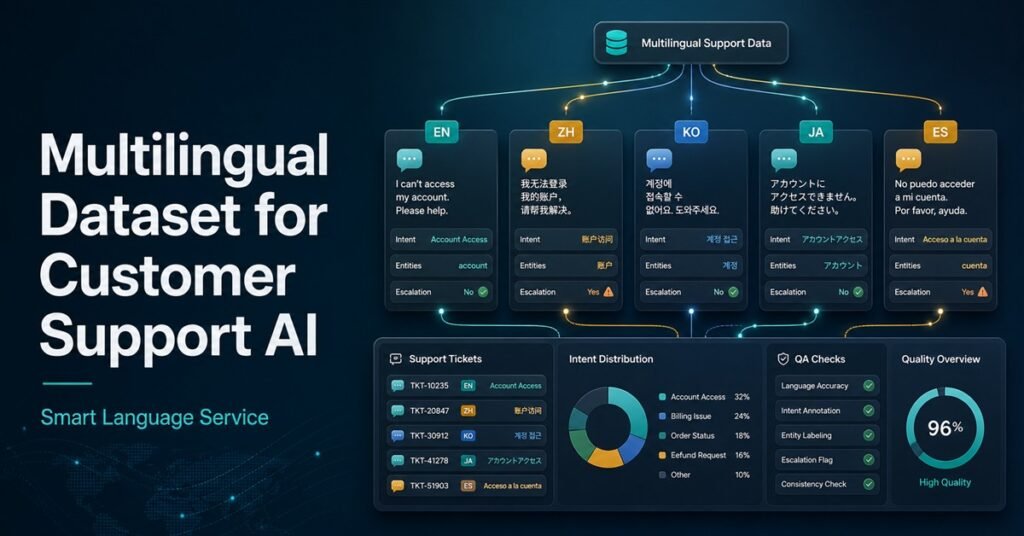
为什么客户支持 AI 的多语言数据集不能只是翻译样本
为客户支持 AI 构建多语言数据集,不能简单地把英文意图列表翻译成其他语言。真实客户不会按照模板说话。他们会使用本地产品叫法、拼写变体、混合语言、缩写、抱怨语气、紧急表达,以及不同市场特有的求助方式。如果数据集没有覆盖这些真实表达,模型可能在测试文件里表现不错,但上线后遇到真实工单和聊天记录时就会失效。
这类数据会影响聊天机器人、工单分流、语音助手、知识库搜索、坐席辅助、情绪分析和多语言服务质量监控。客户支持 AI 通常在用户有问题、有情绪、赶时间或信息不完整的时候发挥作用,因此数据集必须反映真实语言行为,而不是只收集干净、标准、像教材一样的句子。
先从客户支持流程开始,而不是从语言列表开始
稳定的多语言客户支持数据集,首先要明确 AI 要解决什么问题。它是用于把工单分到正确队列,回答常见问题,识别流失风险,总结对话,推荐坐席回复,还是判断什么时候必须转人工?不同目标需要完全不同的数据结构。
意图分类需要有代表性的用户表达和清晰标签;坐席辅助需要客户消息、上下文和可用回复模式;升级风险识别需要覆盖愤怒、紧急、重复联系、账单风险、安全问题和合规敏感请求。如果是语音支持,还可能需要转写、时间戳、说话人标签和噪声相关元数据。
仔细定义意图、实体和升级标签
意图标签是很多客户支持 AI 数据集的核心。如果标签过宽、互相重叠或脱离业务动作,数据就会变弱。例如 technical issue 太笼统,实际支持团队可能需要区分登录失败、集成问题、文件上传错误、账号权限和 API 故障。
实用的标签体系应该与业务动作对应。如果两类客户消息会进入同一处理流程,可以放在一起;如果它们需要不同团队、优先级或知识库内容,就应当拆开。实体同样重要,产品名、订单号、账号类型、地区、设备型号、错误代码、套餐名称和日期,都可能需要被一致识别。
收集原生表达,不要只依赖翻译
翻译可以帮助扩展初始样本,但不应成为多语言数据集的唯一来源。翻译样本通常会保留源语言结构,看起来正确,却不一定像真实客户会说的话。
原生样本能带来更有价值的细节:非正式表达、常见错别字、本地习惯说法、渠道化语言、缩写、礼貌程度和情绪信号。它还能帮助团队发现不同市场真正关心的问题。敏感行业可以使用匿名化历史数据、合成场景或招募写作方式,避免暴露真实客户信息。
数据要包含不完美的语言
客户支持 AI 经常失败,是因为训练数据太干净。真实用户会拼错、切换语言、粘贴错误代码、重复发送、使用俚语、省略背景,或者只写“打不开”“还没收到”“为什么扣费两次”。如果数据集只有完整漂亮的句子,模型就无法适应真实场景。
有价值的数据集应包含短句、长投诉、不完整信息、重复消息、情绪化表达和模糊请求。还应包含容易混淆的相近意图,例如取消订阅和申请退款、重置密码和找回账号。它们能帮助团队检验标签和指南是否足够清晰。
从一开始就把 QA 放进流程
质量控制不能等到最终交付时才做。多语言客户支持 AI 数据集需要在意图设计、语言收集、标注、复核和最终验证的每一步进行 QA。第一批样本如果暴露出标签混淆、示例不自然或市场覆盖不足,就应先修正指南,再进入大规模生产。
高风险类别需要定向抽检,例如退款、法律投诉、安全问题、账号访问、付款失败和强烈负面情绪。这些场景一旦模型判断错误,很容易损害客户信任。
隐私和合规必须提前设计
客户支持数据可能包含姓名、地址、电话、邮箱、付款信息、健康信息、账号 ID 和情绪化投诉。因此,多语言客户支持 AI 数据集必须从一开始就设计隐私控制。
Smart Language Service 可以帮助团队构建面向客户支持 AI 的多语言数据集,覆盖文本、语音、转写、标注、翻译和 QA 流程。我们支持意图设计、原生语言样本创建、实体标注、升级风险标签、多语言复核管理和隐私友好的交付。