
データアノテーション品質管理が重要な理由
データアノテーション品質管理は、有用な AI 学習データを構築するうえで非常に重要です。モデルは与えられた構造、ラベル、例から学習します。ラベルが一貫していない、ガイドラインが曖昧、レビューが最後のバッチだけに集中している場合、プロジェクトは完了したように見えても、データセットには品質上の問題が残る可能性があります。
AI チームにとって、品質管理は個々のミスを修正するだけではありません。避けられるエラーを防ぎ、曖昧なケースを早期に見つけ、大規模なアノテーションチームが同じ基準で作業できるようにするワークフローを設計することです。多言語プロジェクト、専門分野のデータセット、文脈によってラベル判断が変わるタスクでは特に重要です。
品質はラベリング前から始まります
安定したアノテーションプロジェクトは、明確なタスク設計から始まります。作業を割り当てる前に、ラベル体系、受け入れ基準、境界ケース、却下ルール、各ラベルの例を定義する必要があります。良いガイドラインは正解だけを示すのではなく、難しいケースでなぜ一方のラベルがもう一方より適切なのかも説明します。
パイロットアノテーションも不可欠です。小規模なパイロットは、曖昧な指示、不足しているラベル、分かりにくい例、非現実的な処理量の想定を明らかにします。パイロットでアノテーター間の意見差が出ることは失敗ではありません。本格運用前にガイドラインを改善できる有用な証拠です。
レビュアー校正は判断基準のずれを防ぎます
レビュアー校正は見落とされがちです。レビュアーが異なる基準を適用すると、アノテーターが丁寧に作業しても最終データセットは一貫しません。本番作業の前に、レビュアーは同じサンプルを確認し、判断の違いを比較し、難しいケースの扱いを合意する必要があります。
校正はプロジェクト中も継続すべきです。データが増えると新しい境界ケースが出てきます。これらは一人のレビュアーが個別に解決するのではなく、ガイドラインに追加するべきです。そうすることで、各判断が次のバッチの品質改善につながる継続的な品質システムになります。
サンプリングとフィードバックループは手戻りを減らします
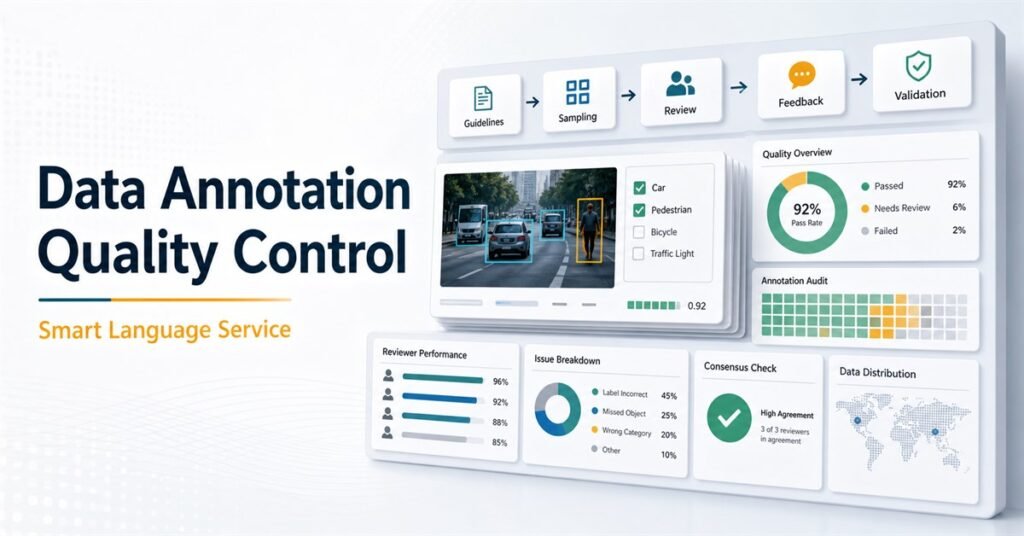
実践的な品質管理ワークフローでは、ランダムサンプリング、重点サンプリング、問題ベースのレビューを組み合わせます。ランダムサンプリングは全体品質を把握するために役立ちます。重点サンプリングは高リスクラベル、新しいアノテーター、難しいコンテンツタイプに集中します。問題ベースのレビューは繰り返し発生するエラーを追跡し、具体的なフィードバックに変えます。
早いフィードバックも重要です。数千件が完了した後に初めてフィードバックが届くと、同じミスがすでにデータセット全体に広がっている可能性があります。短いレビューサイクルは早期修正を可能にし、高コストな手戻りを減らします。
指標は問題を隠すのではなく意思決定を支えるべきです
正解率や一致率は有用ですが、それだけを品質指標にすべきではありません。高い一致率は単にタスクが簡単だったことを示す場合があります。低い一致率はアノテーターの能力不足ではなく、ガイドラインが曖昧であることを示している場合もあります。有用な指標には、ラベル分布、レビュアー修正率、エラータイプの頻度、処理量の変化、未解決の境界ケースが含まれます。
目的は品質がなぜ変化したのかを理解することです。指標が実例やレビュアーメモと結びつくと、プロジェクト管理者はガイドライン更新、再トレーニング、スコープ調整、追加レビュー層の必要性を判断できます。
Smart Language Service の支援
Smart Language Service は、AI チームが実用的で測定可能、かつ拡張可能なアノテーション品質ワークフローを構築できるよう支援します。ガイドライン設計、多言語アノテーションチーム、レビュアー校正、品質サンプリング、フィードバック管理、最終データセット検証に対応します。言語サービスと AI データプロジェクトの経験により、言語、文脈、文化的ニュアンスがラベル品質に影響するタスクも安定して扱えます。
音声、テキスト、画像、多言語データセットを準備するチームにとって、品質管理は最初からプロジェクトに組み込むべきです。QA が最後のチェックポイントではなくワークフローの一部になることで、データセットはより信頼でき、モデル学習プロセスも安心して進められます。