
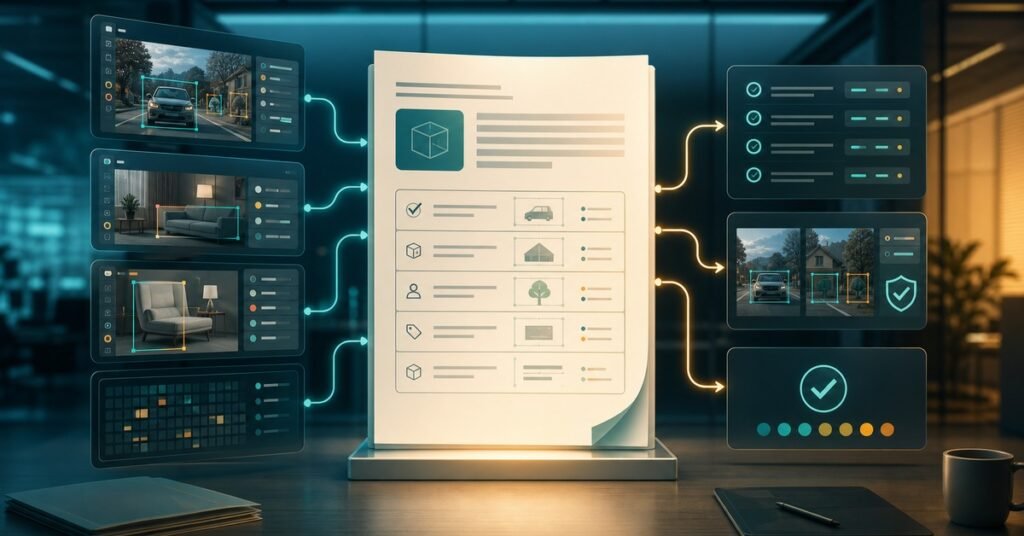
为什么数据标注指南会决定整套数据集的质量
数据标注指南并不只是解释“怎么打标签”。它实际上定义了项目如何把真实世界中复杂、模糊、噪声很多的内容,转化为模型团队可以信任的训练数据。如果指南写得模糊,标注员就会用个人经验去补空白,审核员会反复处理同样的分歧,项目经理往往要等到成千上万条数据已经完成之后,才发现质量问题已经扩散。这也是为什么高质量的数据标注指南,是降低 AI 项目返工成本最便宜、最直接的方法之一。
很多采购方会先关注产能、人数、单价和周期,但真正决定这些投入能否变成可靠数据集的,通常是指南本身。好的指南会在正式生产前建立统一的判断规则,明确标注单位是什么、每个标签代表什么、哪些情况必须升级处理,以及不确定时应该如何操作。没有这层基础,即使是经验丰富的标注团队,也会随着时间推移出现判断漂移。
先定义业务目标,再定义标注单位
优秀的数据标注指南,通常不是从标签列表开始,而是从业务目标开始。团队首先要说清楚:这套数据最终服务于什么任务,是意图分类、命名实体识别、情感分析、文档抽取、内容审核、排序模型,还是其他场景。只有目标任务明确之后,才能准确界定标注单位到底是 token、句子、话轮、图片区域、文档字段,还是整段对话。很多指南失效的根本原因,是标注员从头到尾都不知道模型到底要学会什么。
这一部分还应说明具体的运营背景。标注对象是结构整齐的产品文本,还是噪声较多的用户原始语料?遇到模糊内容时,是应该保留不确定性,还是必须强制选择一个最佳标签?多语言项目中,标注是按原文统一判断,还是按本地市场语境判断?当标签规则和下游产品决策建立联系时,标注员的判断会更稳定,审核反馈也更容易统一。
每个标签都要写清定义、排除条件和优先级
只有标签名称而没有规则,不能算真正的指南。每个标签都应该包含自然语言定义、适用条件、排除条件,以及在多个标签都看似合理时应如何排序。这一点在标签边界重叠、同一文本片段可能对应不同实体类型、或标注员需要在字面含义和业务意图之间做判断时尤其关键。
优先级规则往往正是减少返工的关键。如果指南明确写明“安全投诉优先于一般产品问题”,或“账单意图优先于笼统的不满表达”,审核员后期就不需要频繁推翻前面的结果。好的数据标注指南并不是给团队更多自由,而是提前把冲突显性化,减少临场发挥的空间。
把边界案例、反例和升级路径写进去
标注项目中最昂贵的错误,通常不是发生在简单案例上,而是发生在那些本来可以预见、却没有被写进规则的边界案例上。因此,实用的指南必须包含困难案例、近似案例和反例,明确说明什么时候某个标签不能使用。标注员只有在相似案例之间做过对照,才能真正理解为什么这个结果优先于另一个结果。
升级路径同样重要。无论指南写得多详细,总会存在无法立即判断的样本。指南应明确规定:什么情况下需要跳过、标记、提交复核,而不是强行猜一个答案。这样可以把不确定性保留下来,避免因为“每条都必须给答案”的压力,在数据集中制造看不见的一致性问题。
不要靠假设写指南,要靠试标轮次去打磨
很多团队习惯在会议室里把指南写完,然后默认正式生产会验证它是可行的。更稳妥的做法是,把第一版指南视为不完整草稿,必须通过真实样本的试标来打磨。试标可以暴露定义过宽、示例缺失、产能预估不现实,以及某些错误类型重复出现等问题。只有把这些发现回灌进指南,后续放量才会更稳定。
这也是标注运营与 数据标注质量控制 真正接轨的地方。试标不应只看一致率,还应记录分歧原因、审核改判原因和未解决的边界案例。这些内容才是后续完善指南、清理生产流程的原始材料。
让指南和 QA、审核校准、版本控制真正连起来
一份指南发出去之后,并不代表工作结束。它需要明确负责人、版本历史和更新机制。如果审核员在改判标准时没有同步更新指南,标注员就会继续按旧规则工作,返工会迅速扩散到后续批次。团队应记录每次规则变更、变更原因,以及受影响的数据批次,否则项目很快就会失去可审计性。
审核校准也必须以同一份指南为准。如果标注员和审核员训练时使用的案例不同,那么一致率指标本身就会失真。这种纪律要求与 面向全球团队的技术手册翻译 很相似:如果术语、结构和例外处理不能被集中管理,最终输出就很难在不同人员、不同语言和不同批次之间保持稳定。
项目启动前,采购方应该问哪些问题
在标注项目正式开始之前,采购方应当看的不是“有没有指南”,而是“这份指南将如何被真正用于生产”。成熟的供应商通常可以用非常具体的运营语言解释指南逻辑,并说明复杂案例如何进入反馈闭环。
- 标注单位是什么,它与模型任务如何对应?
- 每个标签如何定义,冲突时哪个标签优先?
- 现有边界案例有哪些,新案例如何补充进指南?
- 标注员不确定时,升级处理路径是什么?
- 指南更新如何做版本管理,并同步到在岗团队?
- 试标结果、审核改判和 QA 发现将如何反向修改指南?
这些问题会把讨论从笼统的“质量承诺”,拉回到真正的运营纪律上。如果供应商无法解释真实样本复核之后指南会怎样变化,那么项目很可能仍然建立在假设上,而不是建立在受控的标注系统上。
Smart Language Service 如何支持标注指南设计
Smart Language Service 帮助 AI 团队设计适用于多语言生产、审核对齐和可量化 QA 的数据标注指南。我们可以支持标签体系设计、示例开发、试标分析、升级逻辑设计,以及面向语言型和领域型数据集的版本化流程更新。目标不只是让项目标得更快,而是让质量在规模扩大后仍然保持稳定。
对于希望减少返工的团队来说,指南质量并不是一个单纯的文档问题,而是一个运营决策问题。当定义、示例和更新机制在项目早期就建立起来,数据集就会更容易管理、更容易审计,也更适合后续模型训练。这通常才是真正的成本节约开始发生的地方。