
为什么数据标注质量控制很重要
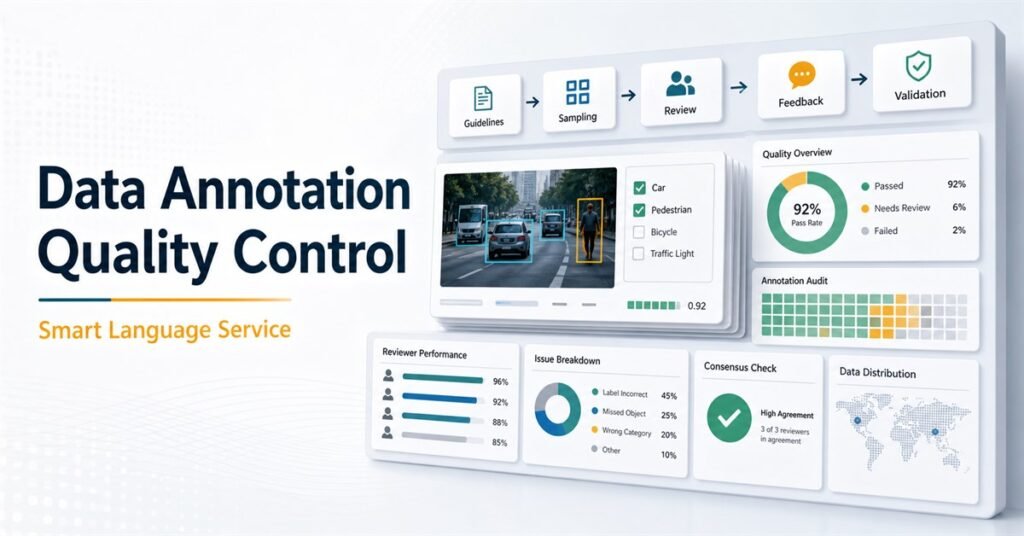
数据标注质量控制是构建高质量 AI 训练数据时最关键的环节之一。模型只能从它接收到的结构、标签和样本中学习。如果标签不一致、规则不清楚,或者审校只放在最后一批完成后才进行,项目表面上可能已经交付,但数据集中仍然隐藏着质量风险。
对 AI 团队来说,标注质量并不只是修改单个错误。更重要的是设计一套流程,提前预防可避免的问题,尽早发现模糊样本,并让较大的标注团队在整个项目周期内保持一致。对于多语言项目、专业领域数据集,以及需要根据上下文判断标签的任务,这一点尤其重要。
质量控制从标注前开始
稳定的数据标注项目应从清晰的任务设计开始。在分配给标注员之前,项目团队需要定义标签体系、验收标准、边界案例、拒收规则,以及每个标签对应的示例。好的标注指南不只是告诉标注员哪个答案正确,还要解释在困难场景中为什么某个标签优于另一个标签。
试标也是必要步骤。小规模试标可以帮助团队发现说明不清、标签缺失、示例混乱、产能预估不现实等问题。如果试标中标注员之间出现分歧,这并不代表项目失败,而是说明指南需要在正式放量前进一步完善。
审校校准可以避免标准不一致
审校校准经常被忽视。如果不同审校员使用不同标准,即使标注员很认真,最终数据集也可能不一致。在正式生产前,审校员应共同处理同一批样本,比对判断差异,并统一困难案例的处理方式。
校准不应该只做一次。随着数据量增加,新的边界案例会不断出现。这些案例应该被补充到指南中,而不是由某个审校员私下解决。这样,项目会形成一个持续更新的质量系统,每一次判断都能改进下一批数据。
抽样和反馈循环可以减少返工
实用的质量控制流程应结合随机抽样、定向抽样和问题驱动审查。随机抽样可以了解整体质量,定向抽样可以关注高风险标签、新标注员或复杂内容类型,问题驱动审查则用于追踪重复错误,并把它们转化为具体反馈。
反馈速度很重要。如果标注员在完成几千条数据后才收到反馈,同一个错误可能已经在数据集中重复了很多次。短周期审校能帮助团队更早调整方向,减少后期返工成本。
指标应该帮助决策,而不是掩盖问题
准确率和一致性分数很有用,但不应该是唯一的质量信号。高一致性可能只是因为任务简单,低一致性也可能说明指南模糊,而不一定代表标注员能力差。更有价值的指标包括标签分布、审校改判率、错误类型频率、产能变化和未解决边界案例数量。
质量指标的目标是解释质量为什么变化。当指标和真实样本、审校备注结合起来时,项目经理才能判断是需要更新指南、重新培训标注员、调整范围,还是增加额外审校层级。
Smart Language Service 如何支持标注质检
Smart Language Service 帮助 AI 团队建立实用、可衡量、可扩展的数据标注质量流程。我们支持标注指南设计、多语言标注团队管理、审校校准、质量抽样、反馈管理和最终数据集验证。我们在语言服务和 AI 数据项目中的经验,能帮助客户处理那些受语言、上下文和文化差异影响的标注任务。
对于正在准备语音、文本、图像或多语言数据集的团队来说,质量控制应从项目开始就嵌入流程,而不是最后才做检查。当 QA 成为工作流的一部分,数据集会更可靠,模型训练结果也更值得信任。