
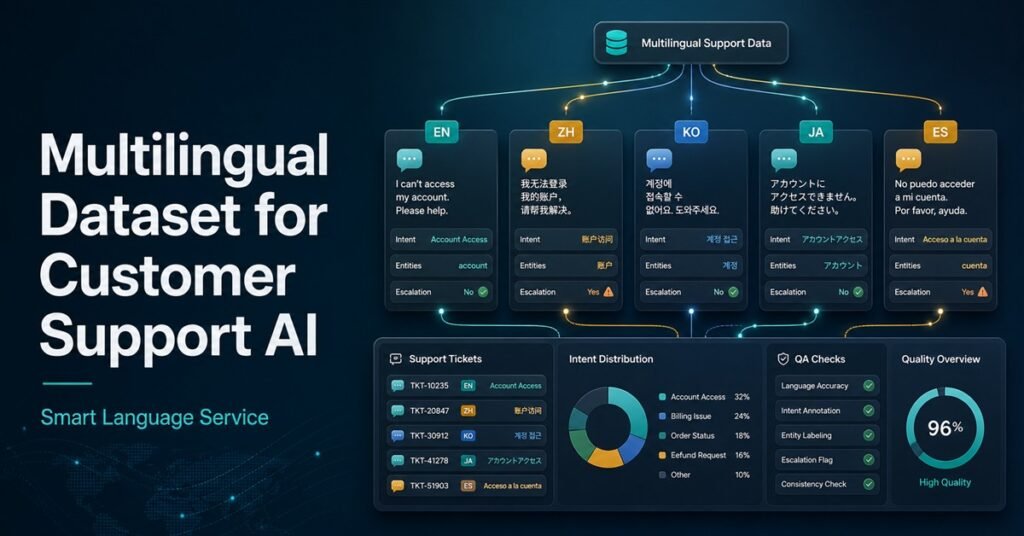
번역된 예문만으로는 충분하지 않습니다
고객 지원 AI를 위한 다국어 데이터셋은 영어 의도 목록을 다른 언어로 번역하는 방식만으로 만들 수 없습니다. 실제 고객은 번역문처럼 말하지 않습니다. 현지 제품명, 철자 오류, 언어 혼용, 짧은 표현, 불만, 긴급 신호, 시장별 문의 습관이 모두 섞입니다. 이런 패턴이 데이터에 없으면 모델은 테스트에서는 좋아 보이지만 실제 상담에서는 약해질 수 있습니다.
이 데이터셋은 챗봇, 티켓 라우팅, 지식 검색, 상담원 보조, 감정 분석, 음성 지원, 다국어 품질 모니터링에 영향을 줍니다. 고객 지원 AI는 사용자가 혼란스럽거나 화가 났거나 시간이 없을 때 평가됩니다. 따라서 데이터는 깨끗한 문장보다 실제 지원 대화의 언어 행동을 반영해야 합니다.
지원 업무 흐름부터 정의합니다
먼저 AI가 어떤 업무를 도와야 하는지 정해야 합니다. 티켓을 올바른 팀으로 보내는지, 자주 묻는 질문에 답하는지, 이탈 위험을 찾는지, 대화를 요약하는지, 상담원 답변을 추천하는지, 또는 사람 상담원에게 넘길 시점을 판단하는지에 따라 필요한 데이터가 달라집니다.
의도 분류에는 대표 발화와 명확한 라벨이 필요합니다. 상담원 보조에는 고객 메시지, 맥락, 적절한 답변 패턴이 필요합니다. 에스컬레이션 감지에는 분노, 긴급성, 반복 문의, 결제 문제, 안전 문제, 법적 리스크 같은 예시가 필요합니다.
의도, 엔티티, 에스컬레이션 라벨을 명확히 합니다
라벨이 너무 넓거나 서로 겹치면 데이터셋은 약해집니다. 예를 들어 기술 문제라는 라벨 하나보다 로그인 실패, 업로드 오류, 권한 문제, API 장애처럼 지원 업무에 맞게 나누는 것이 더 유용할 수 있습니다.
엔티티도 중요합니다. 제품명, 주문번호, 계정 유형, 지역, 기기 모델, 오류 코드, 구독 플랜, 날짜는 일관되게 처리되어야 합니다. 다국어 환경에서는 현지 표기, 약어, 음역, 영어 제품명이 문장 안에 섞이는 경우도 고려해야 합니다.
원어민 표현을 수집합니다
번역은 초기 예시를 확장하는 데 도움이 되지만 유일한 방법이 되어서는 안 됩니다. 번역 예문은 문법적으로 맞아도 실제 고객 메시지처럼 들리지 않을 수 있습니다.
원어민 기반 수집은 비공식 표현, 오타, 채널별 말투, 약어, 공손함의 차이, 불만 표현을 담을 수 있습니다. 또한 각 시장에서 고객이 실제로 무엇을 문제로 느끼는지 보여 줍니다.
실제 대화의 불완전함을 포함합니다
고객 메시지는 짧고, 모호하고, 감정적이며, 때로는 문법적으로 불완전합니다. 작동 안 됨, 아직 못 받음, 왜 두 번 결제됨 같은 짧은 표현도 모델에는 중요합니다. 데이터셋에는 오타, 언어 혼용, 중복 메시지, 긴 불만, 모호한 요청, 서로 헷갈리기 쉬운 의도를 포함해야 합니다.
QA는 처음부터 포함해야 합니다
품질 검사는 최종 단계에만 두면 늦습니다. 의도 설계, 언어 수집, 라벨링, 리뷰, 최종 검증 전 과정에서 QA가 필요합니다. 첫 배치에서 라벨 혼동이나 부자연스러운 표현이 나오면 대량 생산 전에 가이드를 수정해야 합니다.
Smart Language Service는 텍스트, 음성, 전사, 라벨링, 번역, QA를 연결하여 고객 지원 AI용 다국어 데이터셋을 구축할 수 있도록 지원합니다.